반응형
반응형

https://www.youtube.com/watch?v=ODSJsviD_SU

BCC 리서치에 따르면, 휴머노이드 로봇 시장은 2020년 21억달러에서 2025년 79억달러로 커진다고 합니다. 아직 시장이 크지는 않지만 주로 교육과 엔터테인먼트, 의료, 홍보용으로 팔리고 있다고 해요. 개인적으로 알고 있는 핫한 로봇들을 소개해 볼게요.


보스톤다이나믹스 아틀라스

현대차가 인수한 보스톤다이나믹스는 마크 레이버트 MIT대 교수가 창업한 기업인데요. 휴머노이드 로봇인 아틀라스를 2013년에 출시했어요. 이후 달리고, 점프하고, 춤을 추고, 공중제비를 하는 등 인상적인 모습을 보여줬는데요. 인상적인 영상 때문에 로보 사피엔스 시대를 열었다는 평가도 받았습니다. 현재 보스톤다이나믹스는 현대차 뿐 아니라 NASA 미국 육군 소니 등과도 협업을 하고 있고요. 현대차는 4억달러 이상을 로봇 연구소에 투자를 했어요.


쉐도우로봇 컴퍼니

로봇 부품 가운데 가장 만들기 어렵다고 평가 받는 것이 손인데요. 인간의 손은 섬세하지만 로봇의 손은 투박하죠. 잘 못 잡으면 물건이 깨지기도 하고요. 1987년 설립된 쉐도우 로봇 컴퍼니는 손을 주로 연구하는 회사입니다. 특히 택타일 텔레로봇은 세계 첫 햅틱 원격 로봇으로 불려요. 멀리 로봇을 보내더라도 지구에서 장갑을 끼고 로봇 팔을 제어하고 촉감을 느낄 수 있다고 합니다. 특히 그 섬세함은 외과적 정밀도에 가깝다는 평가. 제프 베이조스가 감탄한 기업이기도 합니다.


애질리티 로보틱스

2021년 CES에서 가장 주목을 끈 로봇 기업이기도 합니다. 2017년 처음 이족 로봇을 만들었고 2020년에 걷고 뛰고 계단을 오르는 디짓을 내놓았어요. 야외에서도 사용이 가능하고요. 2019년에는 포드와 협업! 포드의 자율주행차를 타고 다니는 디짓이 상품을 직접 집 앞으로 배송하는 아이디어를 내놓았는데요. 이후 소식이 없다가 얼마 전 100미터를 넘어지지 않고 24초만에 주파했다(영상)는 소식이 있었네요.


도요타의 휴머노이드

도요타 역시 도요타 리서치 인스티튜트를 통해 인공지능과 로봇에 집중하고 있어요. 2016년에 설립된 연구소인데요. 도요타는 그 이전에도 로봇을 선보인 적이 있어요. 특히 2004년에는 트럼펫을 연주하는 로봇을 선보이며 주목을 끌었고, 2005년 엑스포에서 실제로 드럼과 트럼펫을 활용해 음악을 연주하기도 했습니다. 2017년에는 이족 로봇인 T-HR3를 런칭 했는데 10km 거리에서 원격으로 제어를 할 수 있었어요.


🔎 크게보기

휴머노이드 로봇을 만드는 곳은 많지 않지만 갈수록 자동차 회사나 빅테크들 역시 관심이 많은 추세에요. 얼마 전엔 샤오미가 사이버원을 선보이기도 했고요. 일본의 소프트뱅크나 중국의 유비텍, 치한테크 등도 유명한 기업입니다. 또 유럽에선 마코로봇 팔로봇 등이 이름을 떨치고 있어요. 휴머노이드는 아니지만 삼성 LG 아마존은 가정용 로봇에 관심이 많습니다.

반응형
반응형

광주 AI 체험 쇼케이스 가보니…"무인매장서 AI 비전 기술 느껴보니 색다르네


http://www.aitimes.com/news/articleView.html?idxno=141776 


광주 AI 체험 쇼케이스 가보니…"무인매장서 AI 비전 기술 느껴보니 색다르네" - AI타임스

“치O스는 1,200원입니다”“진열된 모든 상품은 인공지능(AI) 데이터로 학습된 상태입니다”“로봇 팔이 컵을 순서대로 카메라에 비추면 컵 속 재료들을 맞춰요”광주영상문화관 1층에 위치한 A

www.aitimes.com

'광주시민 대상 AI 체감 높인다'…AI 기술 체험관 운영돼
시민들, 미래 무인매장 방문해 AI 비전 기술 생생히 느껴
디투리소스, AI 매장관리 주방 무인화 플랫폼 선보여
AI 체험관, 단기적 운영 넘어 지속적 확대‧개선 필요 지적

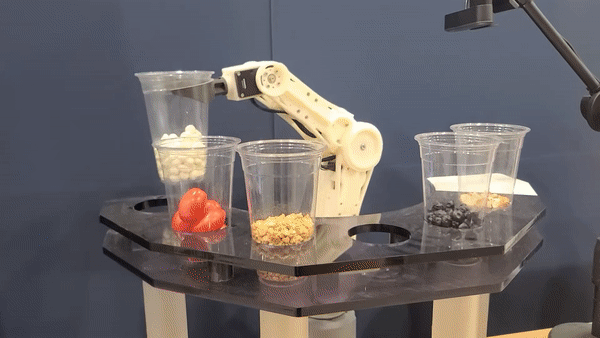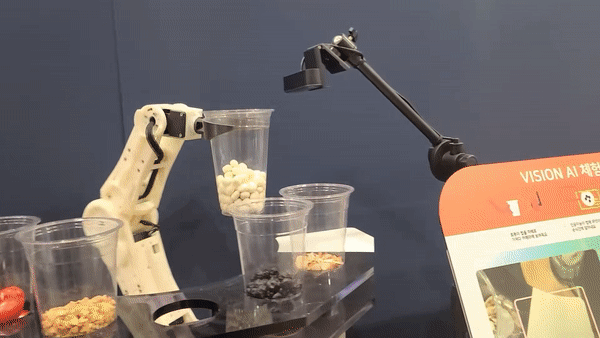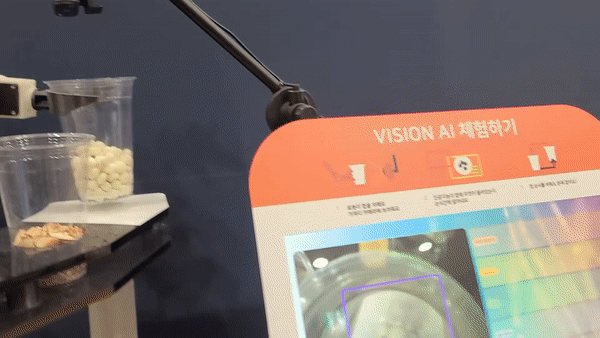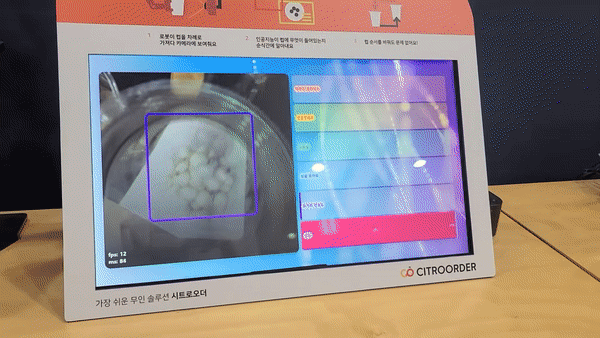
광주영상문화관 1층에 위치한 AI 기술 체험관 ‘인공지능 카페 테스트베드’ 에서는 로봇 팔이 분주하게 움직이는 모습이었다. 컵을 카메라에 비추고, 'AI 영상 비전' 기술로 내용물을 인식하고 있는 모습. (사진=구아현 기자).
반응형
반응형

메가스터디교육, 인공지능(AI) 서비스 본격 시동


메가스터디교육이 인공지능(AI) 서비스 확대 적용을 통한 디지털 역량 강화에 나섰다.

메가스터디교육은 최근 인공지능(AI) 딥러닝 기술을 활용한 '인공지능 음성인식 엔진'을 개발, 올해 안에 관련 서비스를 제공할 예정이다.


'인공지능 음성인식 엔진'은 기존 개발된 범용 엔진에 강사 개별 말하기 특성을 학습시켜 인식 정확도를 높인 것이 특징이다.

기존 85% 수준에 머물던 음성인식 정확도를 95% 이상 끌어올려 한층 업그레이드했다. 이 AI 기술은 강의 자막 등 다양한 서비스에 활용될 예정이다.

이 엔진은 메가스터디교육과 마이스가 협업하여 개발했다.
마이스는 올 2월 메가스터디교육과 인공지능(AI) 기술 기업 스켈터랩스가 교육 분야 AI 기술을 개발하기 위해 설립한 조인트벤처다. 메가스터디교육은 디지털 교육에 필요한 다양한 인공지능 기술을 마이스와 공동 개발할 예정이다.

메가스터디교육은 지난해부터 AI 기술 도입을 위한 본격적인 행보를 지속하고 있다. 올 초에는 대표이사 직속 AI사업부를 신설했으며, AI 기술을 보유하고 있는 스타트업에 대한 투자와 협업을 다각도로 진행하는 등 AI 기술 활용에 적극적으로 나서고 있다.

메가스터디교육 관계자는 "지난 2000년부터 국내 온라인 교육 시장을 선도해온 메가스터디교육이 인공지능(AI)을 접목, 새로운 차원의 교육 서비스를 만들어 갈 계획"이라며 "초등, 중등, 고등, 성인 등 전 사업영역으로 AI 기술을 확대 적용, AI 기술분야를 선도하는 혁신적인 에듀테크 기업으로 성장시킬 것"이라고 말했다.

출처 : 뉴스웍스(http://www.newsworks.co.kr)


https://www.newsworks.co.kr/news/articleView.html?idxno=567985 


메가스터디교육, 인공지능(AI) 서비스 본격 시동 - 뉴스웍스

[뉴스웍스=문병도 기자] 메가스터디교육이 인공지능(AI) 서비스 확대 적용을 통한 디지털 역량 강화에 나섰다.메가스터디교육은 최근 인공지능(AI) 딥러닝 기술을 활용한 '인공지능 음성인식 엔

www.newsworks.co.kr


https://www.news1.kr/articles/?4451817 


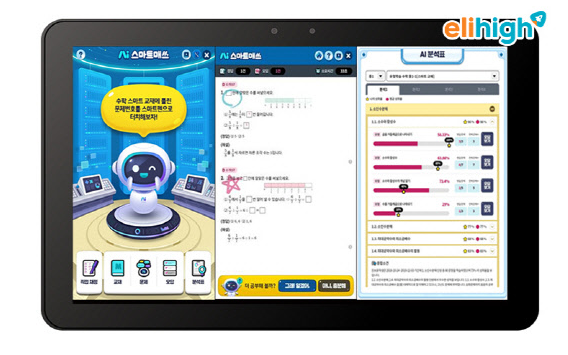
메가스터디교육, 초·중등 학습 서비스 'AI스마트매쓰' 선봬

사실 앞에 겸손한 민영 종합 뉴스통신사 뉴스1

www.news1.kr

메가스터디교육, 초·중등 학습 서비스 'AI스마트매쓰' 선봬

AI 기반 개인별 학습 프로그램 제공

메가스터디교육은 초등 엘리하이와 중등 엠베스트 회원을 대상으로 새로운 인공지능(AI) 기술을 적용한 학습 서비스 'AI스마트매쓰'를 선보인다고 5일 밝혔다.

'AI스마트매쓰'는 기존 '스마트매쓰 플러스'에 개인화 맞춤학습 기능을 더했다. 온라인 학습의 한계를 극복하기 위해 AI를 적극 활용해 학습 시간은 줄이고 편의성은 높이도록 기획됐다.

먼저 AI가 학생 수준을 분석해 같은 문제를 다시 틀리지 않도록 개인별 학습 프로그램을 제공한다.

누적 37만명이 푼 수학 문항을 분석해 개인별 오답 패턴을 정밀하게 파악하고 취약점을 추적, 25만개 문항 중 학생이 꼭 풀어봐야 하는 문제를 선별해 제공한다. 틀린 문제에 대해서는 2차 문제를 추가로 생성해 자주 틀리는 유형을 반복 학습함으로써 오답을 마스터할 수 있도록 설계됐다.

이와 함께 교재 채점 결과를 바탕으로 AI가 분석한 유형별, 난도별, 단원별 종합분석 결과를 확인할 수 있다. 이를 참고로 자신의 취약점을 보완해 나가면 학습 효율성을 높일 수 있다. 초등 1학년부터 중학교 3학년까지 사용할 수 있다.

메가스터디교육은 올 연말부터 교재나 연습장, 필기구를 사용하지 않고 간편한 학습이 가능한 AI서비스도 선보일 계획이다.

이를 위해 실제 종이 연습장에 문제를 푸는 것과 같은 느낌의 손가락 필기인식 기능을 AI를 활용해 개발 중이다. 이 기능을 활용하면 태블릿에서 학생이 손으로 직접 쓰고 문제를 풀면서 수학 개념을 빠르고 편리하게 익힐 수 있다.

반응형
반응형

인공지능(AI) 언어모델 ‘BERT(버트)'는 무엇인가

github.com/google-research/bert


google-research/bert

TensorFlow code and pre-trained models for BERT. Contribute to google-research/bert development by creating an account on GitHub.

github.com

지난해 11월, 구글이 공개한 인공지능(AI) 언어모델 ‘BERT(이하 버트, Bidirectional Encoder Representations from Transformers)’는 일부 성능 평가에서 인간보다 더 높은 정확도를 보이며 2018년 말 현재, 자연 언어 처리(NLP) AI의 최첨단 딥러닝 모델이다. 

또한 BERT는 언어표현 사전학습의 새로운 방법으로 그 의미는 '큰 텍스트 코퍼스(Wikipedia와 같은)'를 이용하여 범용목적의 '언어 이해'(language understanding)' 모델을 훈련시키는 것과 그 모델에 관심 있는 실제의 자연 언어 처리 태스크(질문·응답 등)에 적용하는 것이다.

특히 BERT는 종래보다 우수한 성능을 발휘한다. BERT는 자연언어 처리 태스크를 교육 없이 양방향으로 사전학습하는 첫 시스템이기 때문이다. 교육 없음이란 BERT가 보통의 텍스트 코퍼스만을 이용해 훈련되고 있다는 것을 의미한다. 이것은 웹(Web) 상에서 막대한 양의 보통 텍스트 데이터가 여러 언어로 이용 가능하기 때문에 중요한 특징으로 꼽는다.

사전학습을 마친 특징 표현은 문맥에 '의존하는 방법'와 '의존하지 않는 방법'의 어느 방법도 있을 수 있다. 또 문맥에 의존하는 특징적인 표현은 단방향인 경우와 혹은 양방향일 경우가 있다. word2vec나 GloVe와 같이 문맥에 의존하지 않는 모델에서는, 어휘에 포함되는 각 단어마다 '단어 삽입(word embedding)'이라는 특징 표현을 생성한다. 따라서, 'bank'라는 단어는 'bank deposit' 또는 'river bank'과 같은 특징으로 표현되며, 문맥에 의존하는 모델에서는 문장에 포함되는 다른 단어를 바탕으로 각 단어의 특징을 표현 생성한다.


BERT는 문맥에 의존하는 특징적인 표현의 전학습을 실시하는 대응을 바탕으로 구축되었다. 그러한 대응은 Semi-supervised Sequence Learning, Generative Pre-Training, ELMo, 및 ULMFit를 포함하며, 대응에 의한 모델은 모두 단방향 혹은 얕은 양방향이다. 각 단어는 단지 그 왼쪽(혹은 오른쪽)에 존재하는 단어에 의해서만 문맥의 고려가 되는 것을 의미한다.

예를 들어, I made a bank deposit라는 문장은 bank의 단방향 특징표현은 단지 I made a만에 의해 결정되며, deposit은 고려되지 않는다. 몇개의 이전의 대응에서는 분리한 좌문맥모델과 우문맥모델에 의한 특징표현을 조합하고 있었지만, 이것은 얕은 양방향 방법이다. BERT는 bank를 왼쪽과 오른쪽 양쪽의 문맥 I made a ... deposit을 딥 뉴럴 네트워크(Deposit)의 최하층에서 이용해 특징을 표현하기 때문에 BERT는 '딥 양방향(deeply bidirectional)'이다.

BERT는 간단한 접근법을 사용한다. 입력에서 단어의 15%를 숨기고 딥 양방향 Transformer encoder(관련 논문다운)를 통해 전체 시퀀스를 실행한 다음 마스크 된 단어만 예측한다. 예를 들어, 아래와 같이 문간의 관계를 학습하기 위해서는 임의의 단언어 코퍼스에서 생성 가능한 심플한 작업을 이용하여 학습한다. A와 B의 두 개의 글을 받았을 때 B가 A의 뒤에 오는 실제 문장인지, 코퍼스 안의 랜덤한 글인지를 판정하는 태스크이다.
 

또한 큰 모델(12층에서 24층의 Transformer)을 큰 코퍼스(Wikipedia + BookCorpus)로 긴 시간을 들여(100만 갱신 스텝) 훈련했다. 그것이 BERT이며, 이용은 '사전학습'과 '전이학습'의 2단계로 구분된다.

사전학습(pre-training)은 상당히 고가로 4에서 16개의 Cloud TPU로 4일(12 층의 Transformer 모델의 경우 4개의 TPU를 사용하여 4일, 24층 Transformer 모델의 경우 16개의 TPU를 사용하여 4일이라는 의미) 각 언어마다 1회만의 순서이다. 자연 언어 처리 개발자는 처음부터 자신의 모델을 사전 학습할 필요가 없다.

전이학습(Fine-tuning)은 저렴하며, 논문(아래 참조)과 똑같은 사전학습이 끝난 모델을 사용하여 하나의 Cloud TPU를 이용, 1시간 GPU를 사용하면 2, 3시간만에 재현할 수 있다. 예를 들면 SQuAD는 하나의 Cloud TPU를 이용 30분으로 하나의 시스템으로서는 최첨단(state-of-the-art)인 91.0%의 Dev F1을 달성할 수 있다.

이밖에 BERT의 또 다른 중요한 측면은 많은 종류의 자연 언어 처치 태스크로 인해 매우 쉽게 채택될 수 있다. 논문 중에서 문장 수준 (SST-2 등), 문장 쌍 수준(MultiNLI 등), 단어 수준(NER 등) 스팬 레벨 2 (SQuAD 등)의 태스크에 대해서 거의 태스크 특유의 변경을 실시하는 일 없이, 최첨단 결과를 얻을 수 있는 것을 나타내고 있다.

참고) 'BERT: 언어 이해를 위한 양방향 트랜스포머 사전 학습(BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding)' 논문(다운받기), BERT Google-research의 깃허브(GitHub) (바로가기) 
 

www.aitimes.kr/news/articleView.html?idxno=13117


인공지능(AI) 언어모델 ‘BERT(버트)'는 무엇인가 - 인공지능신문

지난해 11월, 구글이 공개한 인공지능(AI) 언어모델 ‘BERT(이하 버트, Bidirectional Encoder Representations from Transformers)’는 일부 성능 평가에서 인간보다 더 높은 정확도를 보이며 2018년 말 현재, ...

www.aitimes.kr

ebbnflow.tistory.com/151


[BERT] BERT에 대해 쉽게 알아보기1 - BERT는 무엇인가, 동작 구조

● 언어모델 BERT BERT : Pre-training of Deep Bidirectional Trnasformers for Language Understanding 구글에서 개발한 NLP(자연어처리) 사전 훈련 기술이며, 특정 분야에 국한된 기술이 아니라 모든 자연어..

ebbnflow.tistory.com

vhrehfdl.tistory.com/15


슬기로운 NLP 생활 [13] BERT

이전 글 [1] 자연어처리란? [2] Classification Task [3] POS Tagging [4] Stemming, Lemmatizing [5] 형태소 분석기 [6] One-Hot Encoding, Bag Of Word [7] TF-IDF [8] Word2vec [9] Fasttext [10] Glove [11] E..

vhrehfdl.tistory.com


반응형
반응형

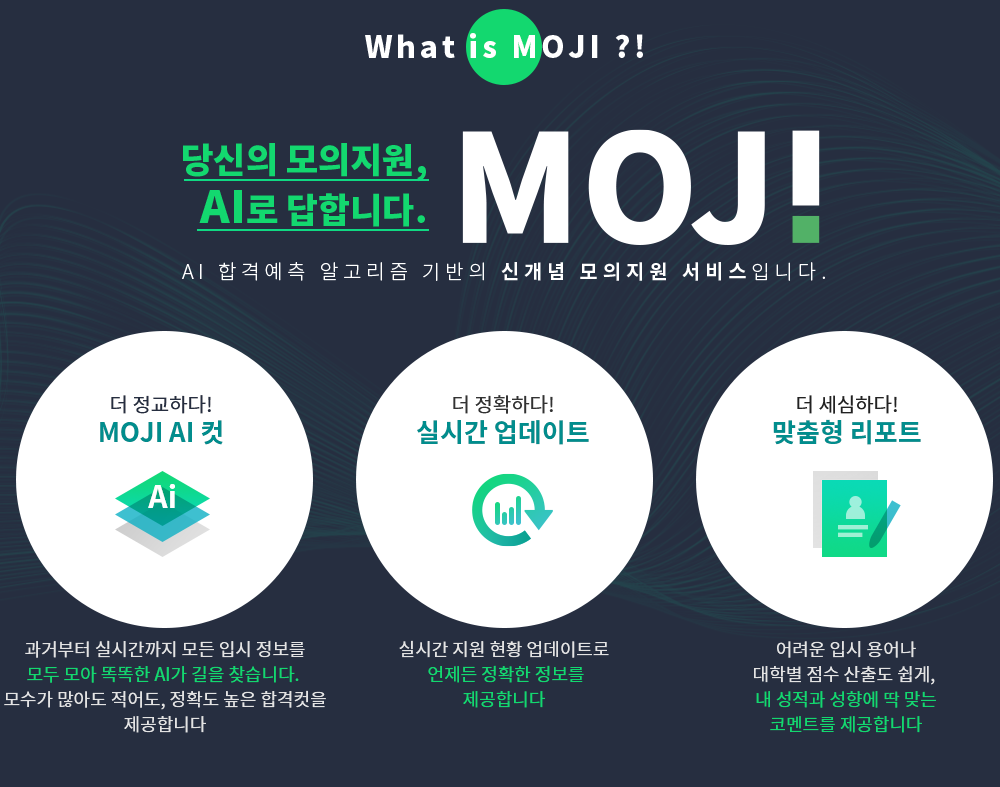
이투스 - Etoos AI모의지원 MOJI


www.mo-ji.co.kr/event/main


MOJI 사전예약 이벤트


www.mo-ji.co.kr


반응형
반응형

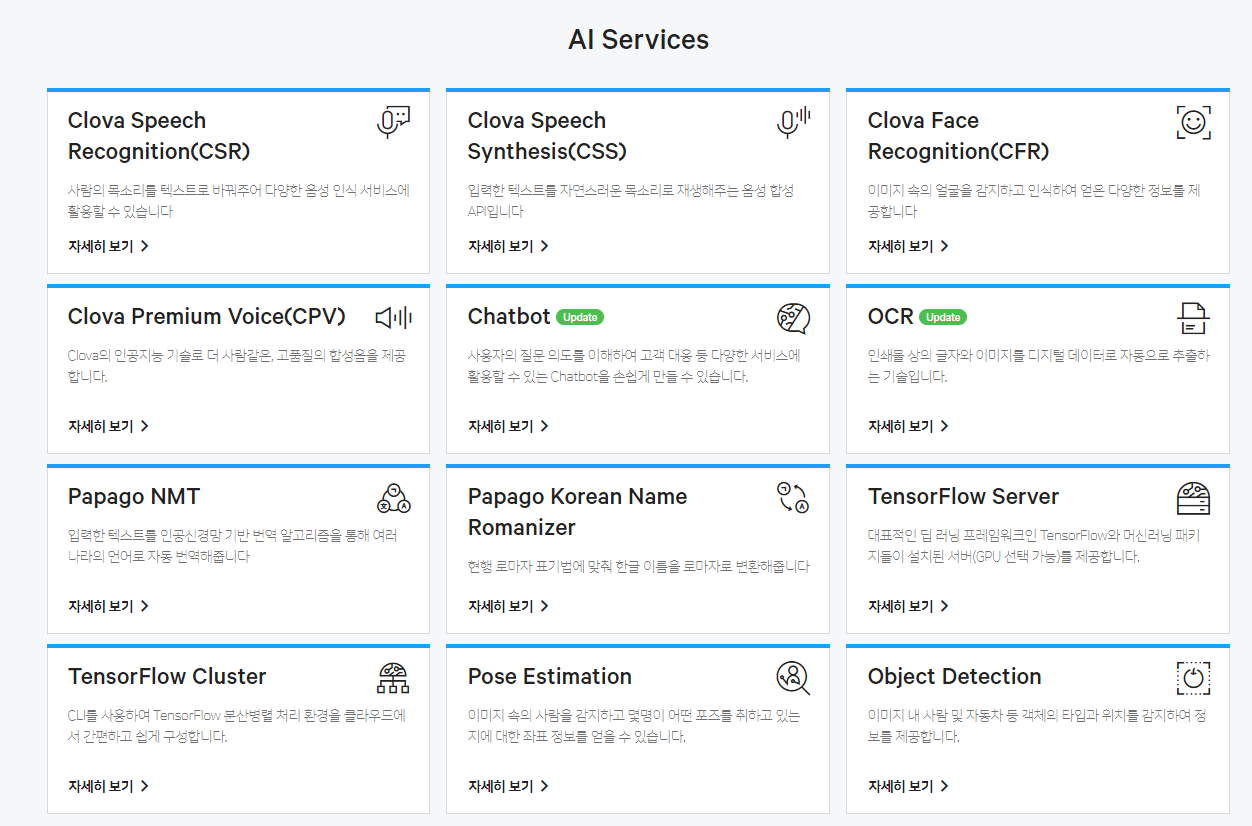
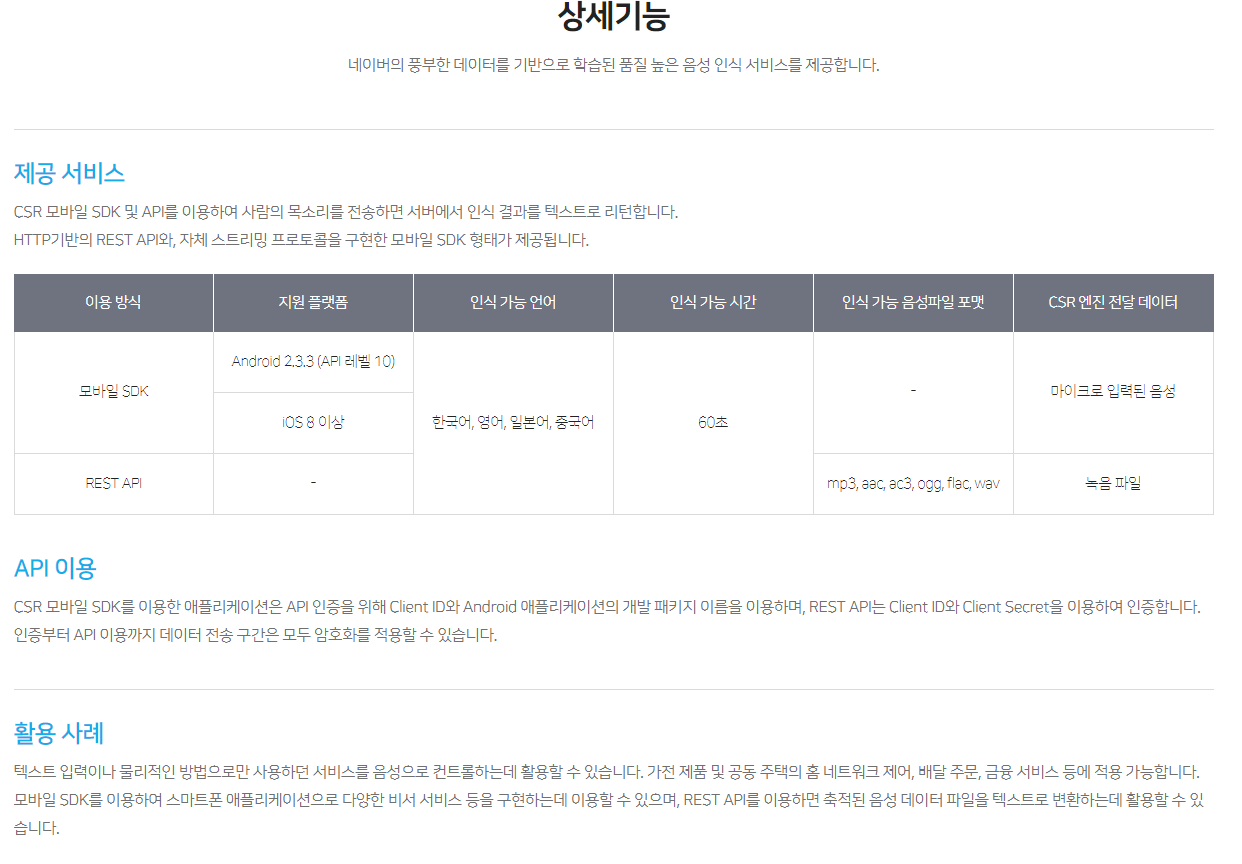
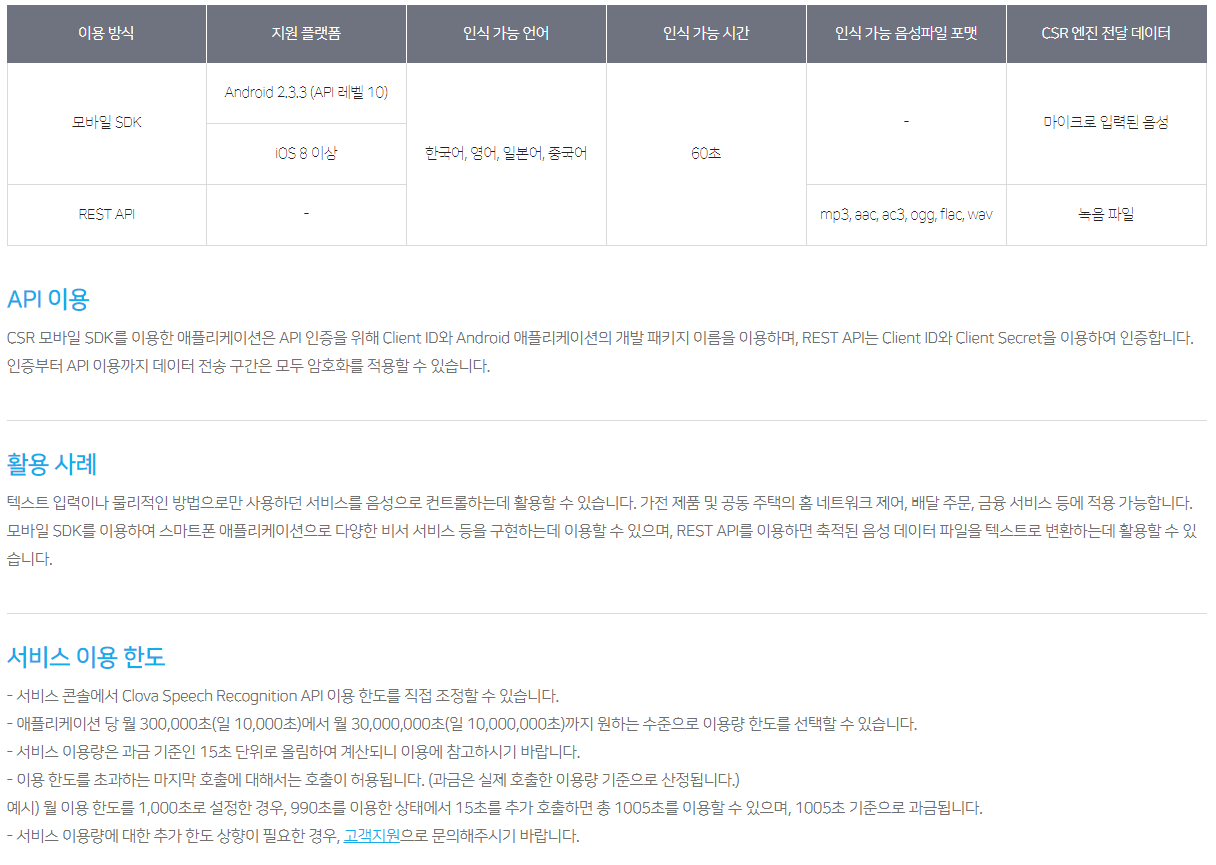
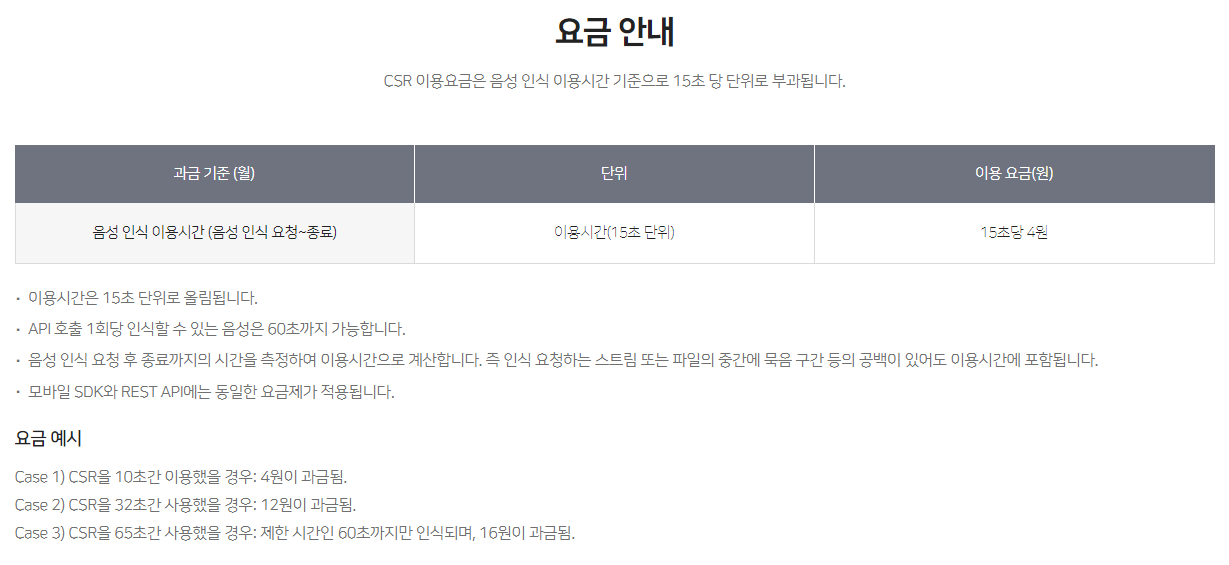
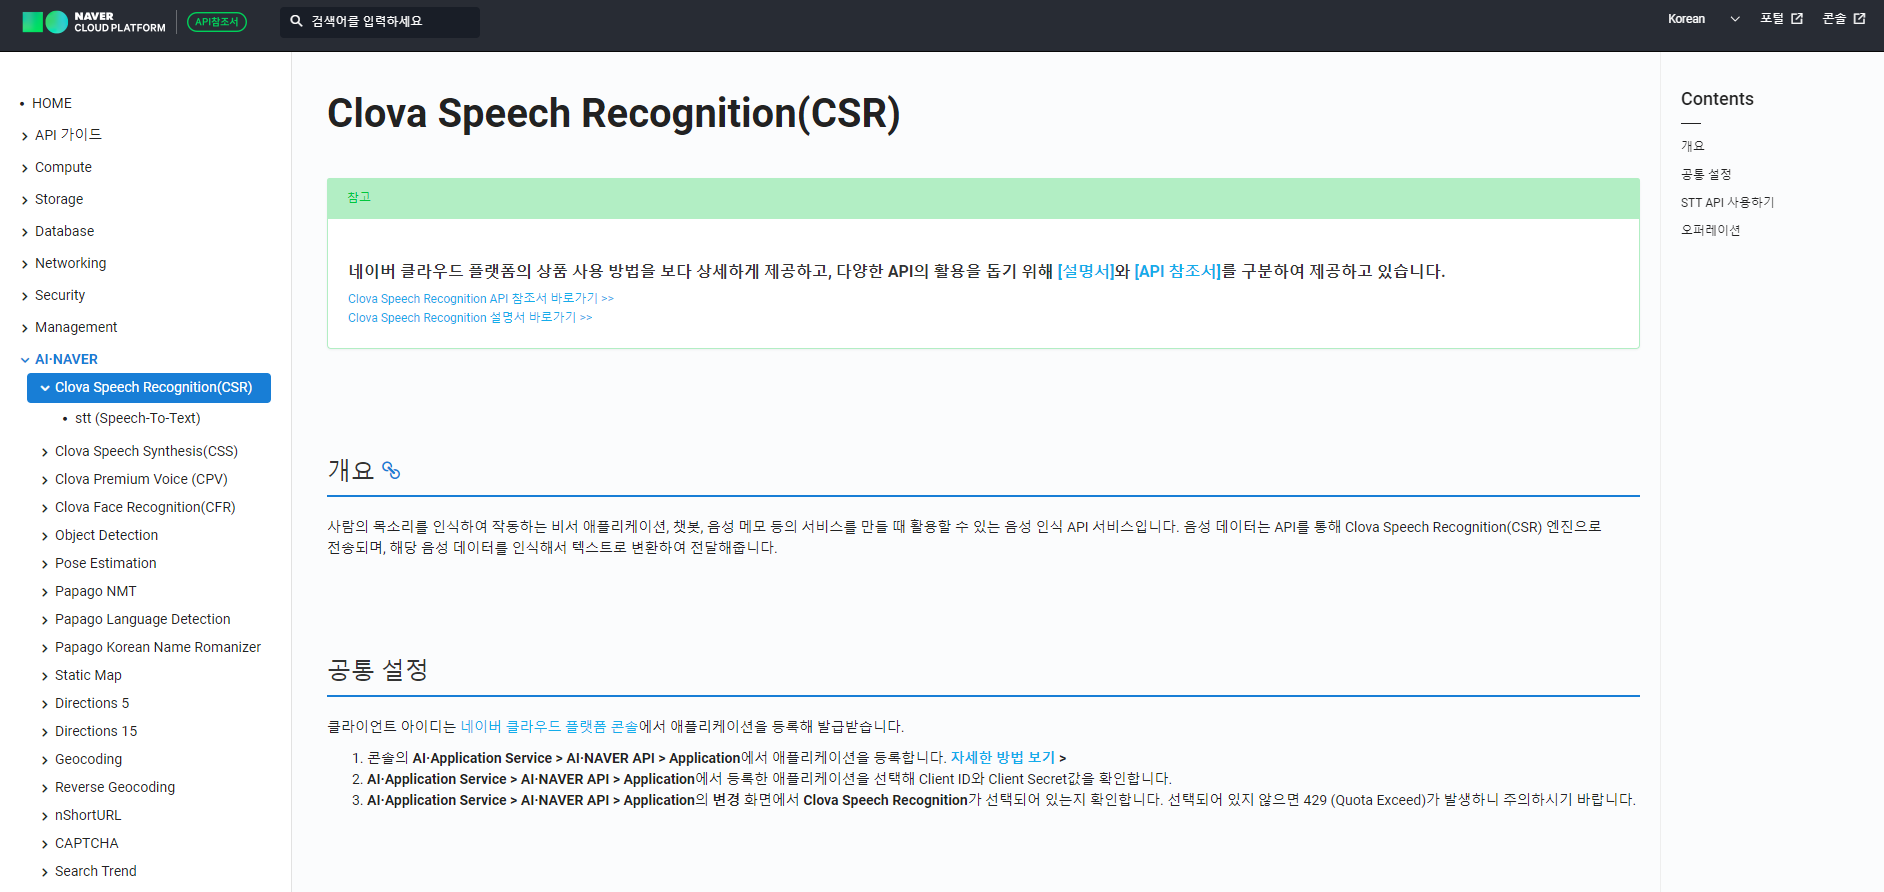
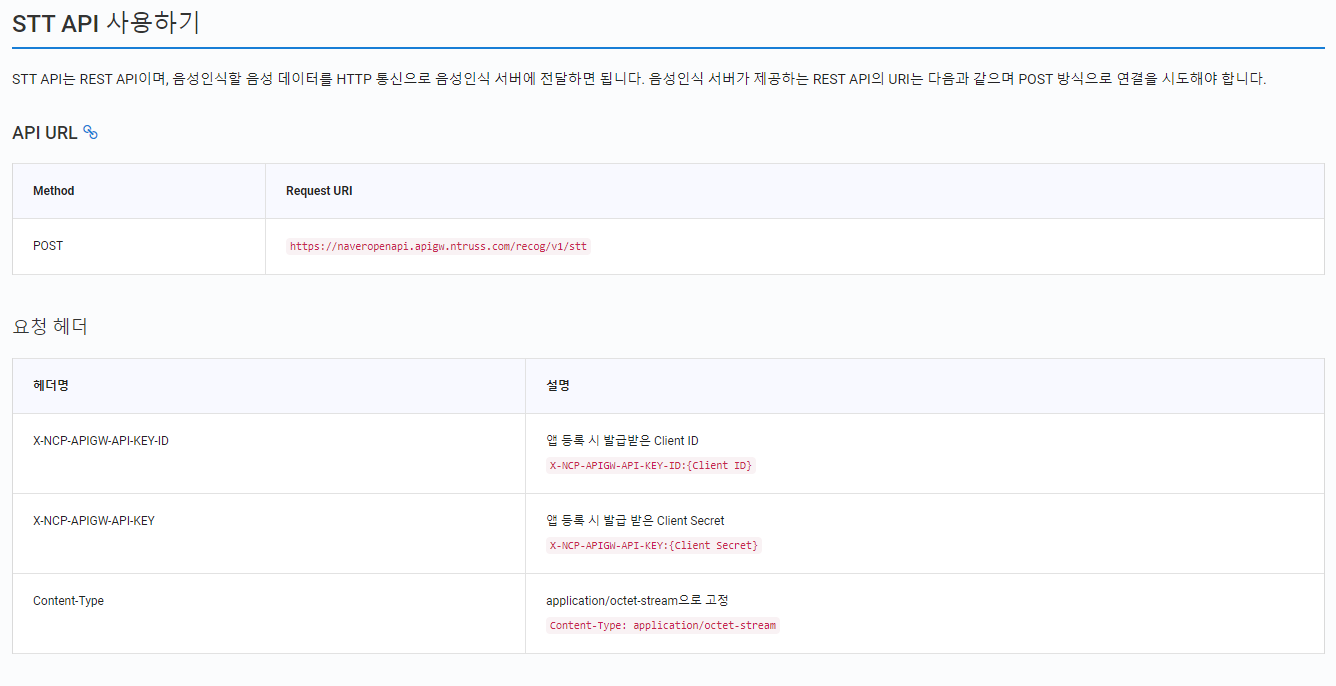
naver AI CSR 

반응형

+ Recent posts