반응형
반응형

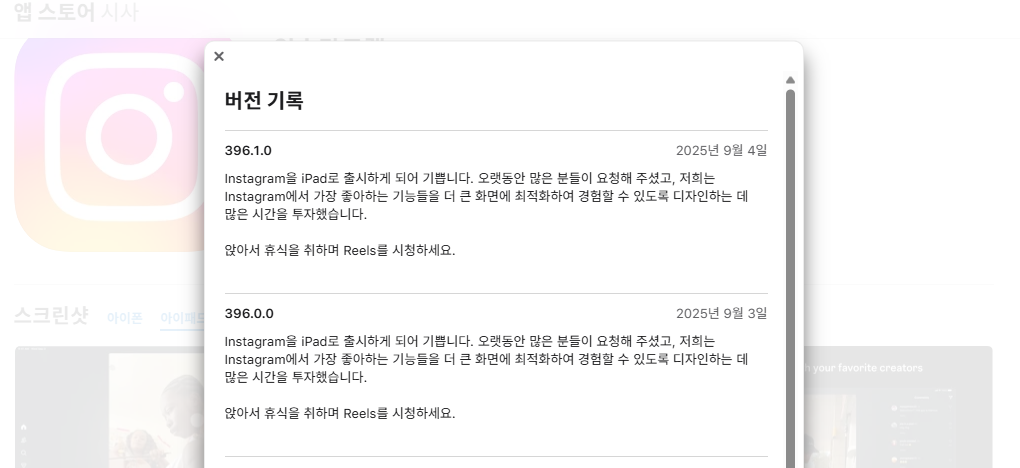
인스타그램, 마침내 iPad 앱 출시 (about.instagram.com)


- 더 편하게 Reels 감상(아이폰 용과 다르게 릴스가 기본 화면. 타임라인은 탭해야 보임)
- 새로운 팔로잉 탭 도입: 전체(팔로우)/친구(맞팔)/최신(시간순) 보기
- 큰 화면에 최적화된 인스타그램 경험
  * 메시지와 알림 두개의 탭을 같이 보기
  * Reels 감상시 전체화면 크기로 재생하며 댓글보기 가능
- iPadOS 15.1 이상
- Instagram - App Store 링크(기존 앱이 iPad도 지원)


https://apps.apple.com/us/app/instagram/id389801252?platform=ipad


‎Instagram

‎Little moments lead to big friendships. Share yours on Instagram. — From Meta Connect with friends, find other fans, and see what people around you are up to and into. Explore your interests and post what's going on, from your daily moments to life's

apps.apple.com


https://about.instagram.com/blog/announcements/instagram-for-ipad/


iPad용 Instagram: 소통, 릴스 시청, 탐색을 더 넓히는 방법

iPad용 Instagram을 소개합니다! 릴스, 스토리, 팔로잉 탭을 더 큰 화면에서 볼 수 있도록 설계된 이 앱에서 소통을 이어가고 계속 재미있게 활동해보세요.

about.instagram.com


반응형
반응형

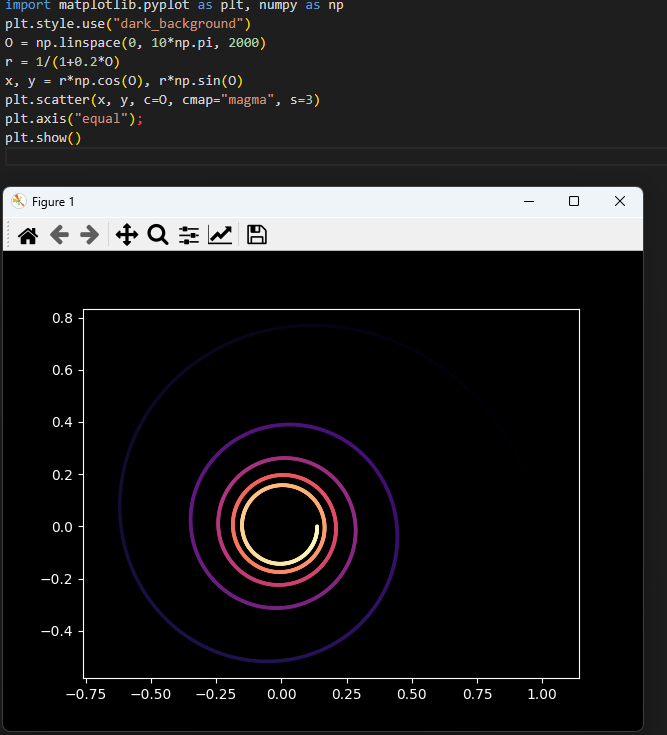
[python] Blackhole Glow using python


import matplotlib.pyplot as plt, numpy as np
plt.style.use("dark_background")
O = np.linspace(0, 10*np.pi, 2000)
r = 1/(1+0.2*O)
x, y = r*np.cos(O), r*np.sin(O)
plt.scatter(x, y, c=O, cmap="magma", s=3)
plt.axis("equal");
plt.show()


반응형
반응형


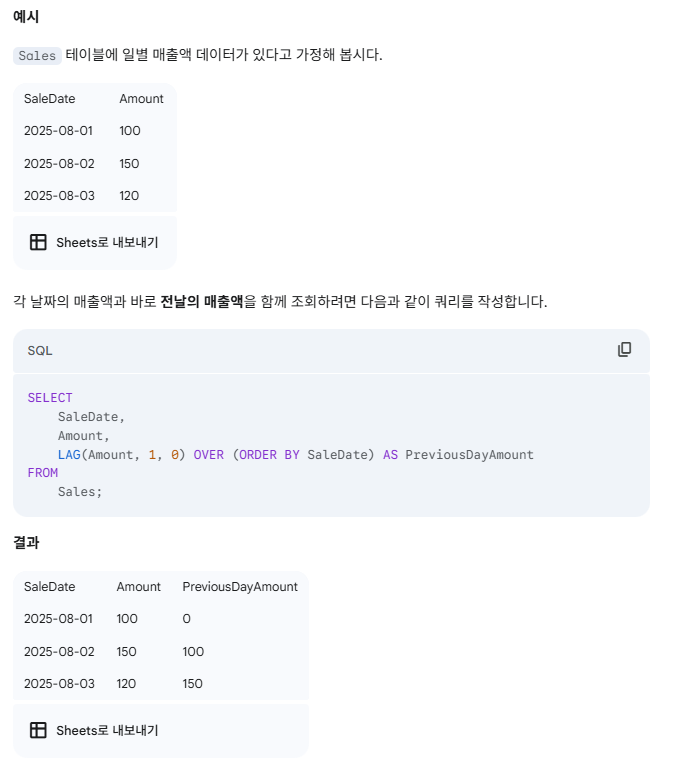
LAG 함수란?

LAG 함수는 SQL 윈도우 함수의 한 종류로, 현재 행을 기준으로 이전 행의 값을 가져오는 역할을 합니다. 주로 시계열 데이터나 순서가 중요한 데이터에서 이전 행의 값과 현재 행의 값을 비교하거나 계산할 때 사용됩니다.


LAG (scalar_expression [, offset] [, default]) OVER (
[PARTITION BY partition_expression, ... ]
ORDER BY sort_expression [ASC | DESC], ...
)


  • scalar_expression: 이전 행에서 가져오고 싶은 컬럼의 이름.
  • offset: 현재 행으로부터 몇 칸 이전의 행을 참조할지 지정합니다. 기본값은 1입니다.
  • default: offset만큼 떨어진 이전 행이 없을 때(보통 첫 번째 행), 반환할 기본값입니다. 기본값은 NULL입니다.
  • PARTITION BY: 데이터를 특정 그룹으로 나눕니다. 그룹이 바뀌면 LAG 연산도 다시 시작됩니다.
  • ORDER BY: 행의 순서를 결정합니다. LAG 함수는 이 순서에 따라 이전 행을 식별합니다.


  • LAG(Amount, 1, 0): Amount 컬럼의 값을 가져오되, 1칸 이전 행의 값을 가져오고, 이전 행이 없을 경우 0을 반환합니다.
  • OVER (ORDER BY SaleDate): 데이터를 SaleDate 오름차순으로 정렬하여 LAG 함수가 순서를 인식하도록 합니다.

LAG 함수는 이처럼 이전 값과의 비교, 이전 대비 변화량 계산, 누적 합계 재계산 등 다양한 분석 작업에 매우 유용합니다.


반응형
반응형


 ./input/ 폴더 안에 있는 엑셀파일을 찾아서 데이터 있는 셀의 앞뒤 공백을 삭제


# pip install pandas openpyxl


"""
    ./input/ 폴더 안에 있는 엑셀파일을 찾아서 데이터 있는 셀의 앞뒤 공백을 삭제

"""

import pandas as pd
import os

# 엑셀 파일이 있는 폴더 경로
input_folder = "./input/"

# 공백이 제거된 파일을 저장할 폴더 (원본 폴더에 저장)
output_folder = "./output/"

# 출력 폴더가 없으면 생성
if not os.path.isdir(output_folder):
    os.makedirs(output_folder)

# input 폴더 내의 모든 파일 목록 가져오기
files = os.listdir(input_folder)

print(f"'{input_folder}' 폴더에서 엑셀 파일을 찾고 있습니다...")

# 파일 목록을 순회
for filename in files:
    # 파일 확장자가 .xlsx 또는 .xls인지 확인
    if filename.endswith(".xlsx") or filename.endswith(".xls"):
        print(f"\n파일 '{filename}' 처리 중...")
        
        # 전체 파일 경로 설정
        file_path = os.path.join(input_folder, filename)
        
        try:
            # 엑셀 파일을 데이터프레임으로 읽어오기
            # 모든 시트를 읽어오기 위해 sheet_name=None 옵션 사용
            #excel_data = pd.read_excel(file_path, sheet_name=None) # 헤더 제외
            excel_data = pd.read_excel(file_path, sheet_name=None, header=0, dtype=str) # 모든 데이터를 문자열로 읽기
            
            # 수정한 내용을 저장할 새로운 엑셀 파일 객체 생성
            output_filepath = os.path.join(output_folder, f"{os.path.splitext(filename)[0]}_cleaned{os.path.splitext(filename)[1]}")
            
            with pd.ExcelWriter(output_filepath, engine='openpyxl') as writer:
                # 각 시트(Sheet)를 순회하며 작업
                for sheet_name, df in excel_data.items():
                    print(f"  - 시트 '{sheet_name}' 공백 삭제 중...")
                    
                    # 문자열 타입의 열만 선택하여 공백 제거
                    for col in df.columns:
                        if df[col].dtype == 'object':
                            # .str.strip() 메서드로 앞뒤 공백 제거
                            #df[col] = df[col].astype(str).str.strip()                            
                            df[col] = df[col].fillna('').astype(str).str.strip() # NaN 값이 있을 때 오류 방지
                            print(df[col])
                    
                    # 수정된 데이터프레임을 새로운 엑셀 파일의 해당 시트에 저장
                    df.to_excel(writer, sheet_name=sheet_name, index=False)
            
            print(f"'{filename}' 파일 처리가 완료되었습니다. '{output_filepath}'에 저장됨.")

        except Exception as e:
            print(f"  - 오류 발생: '{filename}' 파일을 처리할 수 없습니다. 오류: {e}")

print("\n모든 엑셀 파일 처리가 완료되었습니다.")
반응형
반응형

[Just Do Rust - 러스트 기초부터 고급까지](https://wikidocs.net/book/16747)


위키독스

온라인 책을 제작 공유하는 플랫폼 서비스

wikidocs.net


C언어를 처음 접한 것이 1990년입니다. 이후, C++/C#, Java, VBA, Python 등의 언어를 사용했고, 요즘 관심있는 언어가 Rust입니다.

관심 가지는 이유는 C언어의 성능과 Java나 Python 같은 안정성과 편리성을 가지고 있기 때문입니다. 특히, NSA(미국 국가안보국)에서 메모리 안전 문제로 C나 C++ 대신에 Rust와 같은 안전한 언어를 사용하도록 권고 했기에, 미국을 중심으로 기존의 C/C++로 된 코드를 Rust로 바꾸는 작업이 이루어지고 있고, 안전성이 요구되는 프로그램은 Rust로 개발되는 추세여서, 앞으로 Rust 언어의 활용이 많아질 것으로 보이기 때문입니다.

NSA가 권고하는 메모리 안전한 언어Python, Java, C#, Go, Delphi/Object Pascal, Swift, Ruby, Rust, Ada

성능까지 고려하면 Rust가 거의 유일한 C/C++ 대체 언어

필자가 생각하는 향후 Rust가 각광 받을 분야는,

  • 웹서버: 안전성과 성능이 좋아서, 현재 Java로 되어 있는 웹서버쪽은 Rust로 많이 전환될 것으로 예상
  • 암호 라이브러리: C/C++로 되어 있는 암호 라이브러리는 항상 Buffer overflow의 위험을 내재하고 있습니다. 이 부분도 Rust로의 전환이 예상됩니다.
  • 소형 기기 펌웨어: 구글은 이미 Android Virtualization Framework를 Rust로 포팅함. 대부분 C/C++로 작성되어 있어 메모리 안전성이 문제되는 펌웨어 단 모듈들은 Rust로 바꿔질 것임

성능도 좋고 안전하기도 한, 두 마리 토끼를 다 잡은 대신에, Rust 언어를 배우기는 쉽지 않습니다. 안전한 메모리 처리를 위해서 Rust에서 컴파일 전에 체크하는 '소유권', '에러처리', '타입 체크' 등을 개발자가 알아서 코드에 반영해야하기 때문입니다. 그렇지 않으면 아예 컴파일이 되지 않습니다. Java나 파이썬을 배우는 것 대비 2~3배 정도는 시간을 더 들여야 Rust에 익숙해질 것입니다.

이 책은 한국에 있는 개발자를 대상으로 Rust 언어를 보다 쉽게 익숙하게 익힐 수 있도록 제작되었습니다.

효율적으로 공부할 수 있도록, 실제 꼭 알아야하는 부분만을 추릴려고 노력했습니다. 따라서, 이 책에서는 Rust에서 제공하는 모든 내용을 담지는 않습니다. 메뉴얼이 아닙니다.
그러나, 꼭 필요한 부분은 가능한 자세하고 깊게 설명합니다.


챕터 내용을 익히는데 좀 더 도움이 되도록 챕터 내용을 그대로 따라 해볼 수 있는 유튜브 영상 링크입니다.

https://youtu.be/kPLuJgkpYVY


반응형
반응형

[python] python, rust 의 관계


파이썬(Python)과 러스트(Rust)는 서로 경쟁 관계라기보다는 상호 보완적인 관계에 가깝습니다. 두 언어는 설계 철학부터 특징까지 매우 다르며, 각각의 강점을 활용해 시너지를 낼 수 있습니다.


두 언어의 근본적인 차이점

특징 파이썬(Python) 러스트(Rust)
언어 레벨 고수준 언어 (High-level) 저수준 언어 (Low-level)
컴파일 방식 인터프리터 방식 (실행 시 해석) 컴파일 방식 (실행 전 기계어로 변환)
타입 시스템 동적 타입 (Dynamic) 정적 타입 (Static)
메모리 관리 자동 (가비지 컬렉터) 수동 (소유권 시스템)
주요 강점 생산성, 쉬운 문법, 방대한 라이브러리 성능, 안정성, 메모리 안전성
주요 단점 느린 속도, 높은 메모리 사용량 어려운 학습 곡선, 긴 개발 시간


상호 보완적인 관계: 왜 함께 사용하는가?

파이썬은 개발 속도가 빠르고 배우기 쉬워 전체 애플리케이션의 뼈대를 만드는 데 탁월합니다. 하지만 속도가 중요하거나 복잡한 계산을 처리해야 하는 작업에서는 성능의 한계가 명확합니다.

바로 이 지점에서 러스트가 파이썬의 단점을 완벽하게 보완해 줍니다. 러스트는 뛰어난 성능과 메모리 효율성을 자랑하므로, 파이썬으로 만든 애플리케이션의 '병목 현상(bottleneck)'을 해결하는 데 이상적입니다.

예시: 파이썬으로 웹 서버를 구축했다고 가정해 봅시다. 웹 서버의 전체적인 로직은 파이썬으로 빠르게 개발할 수 있습니다. 그러나 특정 요청을 처리하는 과정에서 데이터 분석이나 복잡한 이미지 처리와 같은 고성능 작업이 필요할 수 있습니다.

이 경우, 해당 고성능 작업 부분만을 러스트로 작성합니다. 러스트는 이 작업을 매우 빠르게 처리하고, 그 결과를 다시 파이썬으로 전달해 줍니다. 이렇게 하면 파이썬의 빠른 개발 생산성과 러스트의 탁월한 실행 속도를 모두 얻을 수 있습니다.

실제 협업 방식

러스트로 작성된 코드는 '파이썬 모듈' 형태로 컴파일될 수 있습니다. **PyO3**나 **rust-cpython**과 같은 라이브러리를 사용하면, 러스트의 함수나 클래스를 마치 파이썬 함수처럼 호출할 수 있는 모듈을 쉽게 만들 수 있습니다.

즉, 러스트는 파이썬의 '성능을 위한 보조 도구' 역할을 하며, 파이썬 생태계에 새로운 가능성을 불어넣고 있습니다.


러스트 재단에서 개발되고 있는 메모리 안전성과 성능 및 편의성에 중점을 둔 프로그래밍 언어이다. 가비지 컬렉터 없이 메모리 안전성을 제공하는 대표적인 언어다. C++의 대체재로서 등장했다.

https://youtu.be/5C_HPTJg5ek


반응형

+ Recent posts