반응형
반응형

[DataBase] Postgres를 검색엔진으로 활용하기  


https://anyblockers.com/posts/postgres-as-a-search-engine


Postgres as a search engine

Build a retrieval system with semantic, full-text, and fuzzy search in Postgres to be used as a backbone in RAG pipelines.

anyblockers.com


  • Postgres 내에서 시맨틱, 전문, 퍼지 검색을 모두 갖춘 하이브리드 검색 엔진을 구축할 수 있음
  • 검색은 많은 앱에서 중요한 부분이지만 제대로 구현하기 쉽지 않음. 특히 RAG 파이프라인에서는 검색 품질이 전체 프로세스의 성패를 좌우할 수 있음
  • 의미론적(Semantic) 검색이 트렌디하지만, 전통적인 어휘 기반 검색은 여전히 검색의 중추임
  • 의미론적 기술은 결과를 개선할 수 있지만, 견고한 텍스트 기반 검색의 기반 위에서 가장 잘 작동함

Postgres를 활용한 검색 엔진 구현하기

  • 세 가지 기술을 결합:
    • tsvector를 사용한 전체 텍스트 검색
    • pgvector를 사용한 의미론적 검색
    • pg_trgm을 사용한 퍼지 매칭
  • 이 접근 방식은 모든 상황에서 절대적으로 최고는 아닐 수 있지만, 별도의 검색 서비스를 구축하는 것에 대한 훌륭한 대안임
  • 기존 Postgres 데이터베이스 내에서 구현하고 확장할 수 있는 견고한 출발점
  • Postgres를 모든 것에 사용해야 하는 이유 : 그냥 Postgres를 모든 곳에 사용하세요, PostgreSQL로 충분하다, 그냥 Postgres 쓰세요

FTS와 의미론적 검색 구현

  • Supabase에 하이브리드 검색 구현에 대한 훌륭한 문서가 있으므로, 이를 시작점으로 삼을 것임
  • 가이드에 따라 GIN 인덱스를 사용하여 FTS를 구현하고, pgvector(bi-encoder dense retrieval이라고도 함)를 사용하여 의미론적 검색을 구현함
  • 개인적인 경험으로는 1536차원의 임베딩을 선택하는 것이 훨씬 더 나은 결과를 얻을 수 있음
  • Supabase 함수를 CTE와 쿼리로 대체하고, 매개변수 앞에 $를 붙임.
  • 여기서는 RRF(Reciprocal Ranked Fusion)를 사용하여 결과를 병합함
  • 이 방법은 여러 목록에서 높은 순위를 차지하는 항목이 최종 목록에서 높은 순위를 부여받도록 보장함
  • 또한 일부 목록에서는 높은 순위지만 다른 목록에서는 낮은 순위인 항목이 최종 목록에서 높은 순위를 부여받지 않도록 보장함
  • 순위를 분모에 넣어 점수를 계산하면 순위가 낮은 레코드에 불이익을 줄 수 있음
  • 주목할 만한 사항
    • $rrf_k: 첫 번째 순위 항목의 점수가 극단적으로 높아지는 것을 방지하기 위해(순위로 나누기 때문에), 분모에 k 상수를 추가하여 점수를 평활화하는 경우가 많음
    • $ _weight: 각 방법에 가중치를 할당할 수 있음. 이는 결과를 조정할 때 매우 유용함

퍼지 검색 구현하기

  • 이전까지의 방법으로도 많은 부분을 해결할 수 있지만, 명명된 엔티티에서 오타가 있을 경우 즉각적인 이슈가 발생할 수 있음
  • 의미론적 검색은 유사성을 포착하여 이러한 이슈 중 일부를 제거하지만, 이름, 약어 및 의미론적으로 유사하지 않은 기타 텍스트에 대해서는 어려움을 겪음
  • 이를 완화하기 위해 pg_trgm 확장을 도입하여 퍼지 검색을 허용
    • 트라이그램으로 작동함. 트라이그램은 단어를 3자 시퀀스로 분해하기 때문에 퍼지 검색에 유용
    • 이를 통해 오타나 약간의 변형이 포함되어 있더라도 유사한 단어를 매칭할 수 있음
    • 예를 들어 "hello"와 "helo"는 많은 트라이그램을 공유하므로 퍼지 검색에서 더 쉽게 매칭될 수 있음
  • 원하는 열에 대해 새 인덱스를 생성하고, 그 후 전체 검색 쿼리에 추가
  • pg_trgm 확장은 % 연산자를 노출하여 유사도가 pg_trgm.similarity_threshold(기본값은 0.3)보다 큰 텍스트를 필터링함
  • 유용한 다른 여러 연산자도 있음.

전문 검색 튜닝하기

  • tsvector 가중치 조정하기 :실제 문서에는 제목뿐만 아니라 내용도 포함됨
  • 열이 여러 개 있어도 임베딩 열은 하나만 유지함
  • 개인적으로 여러 임베딩을 유지하는 것보다 title과 body를 같은 임베딩에 유지하는 것이 성능에 큰 차이가 없다는 것을 발견함
  • 결국 title은 본문의 간단한 표현이어야 함. 필요에 따라 이를 실험해 보는 것이 좋음
  • title은 짧고 키워드가 풍부할 것으로 예상되는 반면, body는 더 길고 더 많은 세부 정보를 포함할 것임
  • 따라서 전체 텍스트 검색 열이 서로 어떻게 가중치를 부여하는지 조정해야 함
  • 문서에서 단어가 있는 위치나 중요도에 따라 우선순위를 부여할 수 있음
    • A-weight: 가장 중요(예: 제목, 헤더). 기본값 1.0
    • B-weight: 중요(예: 문서 시작 부분, 요약). 기본값 0.4
    • C-weight: 표준 중요도(예: 본문 텍스트). 기본값 0.2
    • D-weight: 가장 덜 중요(예: 각주, 주석). 기본값 0.1
  • 문서 구조와 애플리케이션 요구사항에 따라 가중치를 조정하여 관련성을 미세 조정함
  • 제목에 더 많은 가중치를 부여하는 이유
    • 제목은 일반적으로 문서의 주요 주제를 간결하게 표현하기 때문
    • 사용자는 검색할 때 먼저 제목을 훑어보는 경향이 있으므로 제목의 키워드 일치는 일반적으로 본문 텍스트의 일치보다 사용자의 의도와 더 관련이 있음

길이에 따른 조정

  • ts_rank_cd 문서를 읽어보면 정규화 매개변수가 있다는 것을 알 수 있음.
    • 두 랭킹 함수 모두 문서의 길이가 순위에 어떤 영향을 미쳐야 하는지 여부를 지정하는 정수 normalization 옵션을 사용함. 정수 옵션은 여러 동작을 제어하므로 비트 마스크임: |를 사용하여 하나 이상의 동작을 지정할 수 있음(예: 2|4).
  • 이러한 다양한 옵션을 사용하여 다음을 수행 가능
    • 문서 길이 편향 조정
    • 다양한 문서 집합에서 관련성 균형 조정
    • 일관된 표현을 위해 랭킹 결과 조정
  • 제목에는 0(정규화 없음), 본문에는 1(로그 문서 길이)을 설정하면 좋은 결과를 얻을 수 있음
  • 다시 말하지만, 사용 사례에 가장 적합한 옵션을 찾기 위해 다양한 옵션을 실험해 보는 것이 좋음

크로스 인코더를 사용한 재랭킹

  • 많은 검색 시스템은 두 단계로 구성됨
  • 즉, 양방향 인코더를 사용하여 초기 N개의 결과를 검색한 다음, 크로스 인코더를 사용하여 이러한 결과를 검색 쿼리와 비교하여 순위를 매김
    • 양방향 인코더(bi-encoder) : 빠르기 때문에 많은 수의 문서를 검색하는 데 좋음
    • 크로스 인코더(cross-encoder)
      • 더 느리지만 성능이 더 좋아 검색된 결과의 순위를 다시 매기는 데 좋음
      • 쿼리와 문서를 함께 처리하여 둘 사이의 관계에 대한 더 미묘한 이해를 가능하게 함
      • 이는 계산 시간과 확장성을 희생하면서 더 나은 랭킹 정확도를 제공함
  • 이를 수행하기 위한 다양한 도구들이 있음
  • 가장 좋은 것 중 하나는 Cohere의 Rerank임
  • 또 다른 방법은 OpenAI의 GPT를 사용하여 자체적으로 구축하는 것임
  • 크로스 인코더는 쿼리와 문서 간의 관계를 더 잘 이해할 수 있도록 하여 검색 결과의 정확도를 높일 수 있음
  • 그러나 계산 비용이 크기 때문에 확장성 면에서는 제한이 있음
  • 따라서 초기 검색에는 양방향 인코더를 사용하고, 검색된 소수의 문서에 대해서만 크로스 인코더를 적용하는 두 단계 접근 방식이 효과적임

언제 대안 솔루션을 찾아야 할까

  • PostgreSQL은 많은 검색 시나리오에 적합한 선택이지만 한계가 없는 것은 아님
  • BM25와 같은 고급 알고리듬의 부재는 다양한 문서 길이를 처리할 때 느껴질 수 있음
  • PostgreSQL의 전체 텍스트 검색은 TF-IDF에 의존하므로 매우 긴 문서와 대규모 컬렉션의 희귀 용어에 어려움을 겪을 수 있음
  • 대안 솔루션을 찾기 전에 반드시 측정해 보아야 함. 그럴 가치가 없을 수도 있음

결론

  • 이 글에서는 기본적인 전체 텍스트 검색부터 퍼지 매칭, 의미론적 검색, 결과 부스팅과 같은 고급 기술까지 많은 내용을 다루었음
  • Postgres의 강력한 기능을 활용하여 특정 요구사항에 맞춘 강력하고 유연한 검색 엔진을 만들 수 있음
  • Postgres는 검색을 위해 가장 먼저 떠오르는 도구는 아니지만 정말 멀리 갈 수 있게 해줌
  • 훌륭한 검색 경험을 위한 핵심
    • 지속적인 반복과 미세 조정
    • 논의한 디버깅 기법을 사용하여 검색 성능을 이해하고, 사용자 피드백과 행동을 기반으로 가중치와 매개변수를 조정하는 것을 두려워하지 말아야 함
  • PostgreSQL은 고급 검색 기능이 부족할 수 있지만, 대부분의 경우 충분히 강력한 검색 엔진을 구축할 수 있음
  • 대안 솔루션을 찾기 전에 먼저 Postgres의 기능을 최대한 활용하고 성능을 측정해 보는 것이 좋고, 그래도 부족하다면 그때 다른 솔루션을 고려해 볼 수 있음

https://news.hada.io/topic?id=16468&utm_source=weekly&utm_medium=email&utm_campaign=202436


Postgres를 검색엔진으로 활용하기 | GeekNews

Postgres 내에서 시맨틱, 전문, 퍼지 검색을 모두 갖춘 하이브리드 검색 엔진을 구축할 수 있음검색은 많은 앱에서 중요한 부분이지만 제대로 구현하기 쉽지 않음. 특히 RAG 파이프라인에서는 검색

news.hada.io


반응형
반응형

Classic ASP에서 GUID 생성 방법


Classic ASP에서 브라우저에 접속한 사용자의 고유한 키 값을 생성하기 위해 주로 사용하는 방법은 **GUID(Globally Unique Identifier)**를 생성하는 것입니다. GUID는 전 세계에서 유일한 값을 가지도록 설계된 128비트 값으로, 사용자의 고유 세션이나 식별자를 만들 때 유용합니다.

Classic ASP에서 GUID 생성 방법

ASP에서 GUID를 생성하는 가장 쉬운 방법은 Scriptlet.TypeLib을 사용하여 GUID를 만드는 것입니다. 다음은 Classic ASP에서 GUID를 생성하여 고유 키를 얻는 코드입니다.

<%
Function GenerateGUID()
    Dim objTypeLib
    Set objTypeLib = CreateObject("Scriptlet.TypeLib")
    GenerateGUID = objTypeLib.Guid
    Set objTypeLib = Nothing
End Function

' 생성된 GUID 호출 예제
Dim uniqueKey
uniqueKey = GenerateGUID()

' 브라우저에 출력
Response.Write "Generated Unique Key: " & uniqueKey
%>

설명

  1. CreateObject("Scriptlet.TypeLib"): Scriptlet.TypeLib 객체는 GUID를 생성할 수 있는 COM(Component Object Model) 객체입니다.
  2. GenerateGUID = objTypeLib.Guid: .Guid 속성을 호출하면 GUID 값을 반환합니다. 이 값은 일반적으로 { }로 감싸진 문자열로 출력됩니다.
  3. 고유한 키 사용: 생성된 uniqueKey를 쿠키, 세션 변수 등에 저장하여 사용자 식별 등에 사용할 수 있습니다.

고유 키 생성 방법의 활용

  • 세션 관리: 로그인 세션 관리에 활용할 수 있습니다.
  • 추적 및 분석: 방문자를 추적하거나 분석할 때 유용합니다.
  • 데이터베이스 키: 사용자별 고유한 데이터베이스 키로 사용할 수 있습니다.

이 방법을 사용하면 Classic ASP에서 손쉽게 고유한 키 값을 생성하여 사용할 수 있습니다.

반응형
반응형

국방부, 민간 클라우드로 네이버 선택…메가존이 시스템 구축


https://www.etnews.com/20240821000163?mc=nl_001_00013&mi=369351


국방부, 민간 클라우드로 네이버 선택…메가존이 시스템 구축

국방부가 네이버클라우드 기반에서 신규 시스템을 구축한다. 클라우드 전문성을 보유한 메가존이 구축 전반을 이끈다. 국방부 내 첫 민간 클라우드 기반 시스템 구축 사례로 향후 공공 민간 클

www.etnews.com

국방부가 네이버클라우드 기반에서 신규 시스템을 구축한다. 클라우드 전문성을 보유한 메가존이 구축 전반을 이끈다.

국방부 내 첫 민간 클라우드 기반 시스템 구축 사례로 향후 공공 민간 클라우드 확산에도 선례가 될 전망이다.

21일 업계에 따르면 국방부는 최근 '장병체감형 원스톱 서비스 플랫폼 구축 사업' 우선협상대상자를 선정했다.

이 사업은 입영 전부터 복무 중, 전역 후 등 장병 전주기에 걸쳐 원스톱 서비스를 제공하기 위해 기획됐다. △장병 행정 △장병 복지 △군장병 역량강화 △보건·의료 등 장병지원 4대 분야 서비스를 연계·통합한 것이 특징이다.

민간 클라우드 기반에서 시스템을 구현하다는 점에서 업계 주목을 받았다.

20일 진행한 사업자 평가 결과 네이버클라우드를 제안한 메가존이 평점(기술·가격) 1위로 우선협상자가 됐다.

이 사업을 의욕적으로 준비했던 삼성SDS는 자체 클라우드인 삼성클라우드플랫폼(SCP)을 제안했지만 가격과 기술 평가 모두 근소한 차이로 밀렸다.

메가존과 네이버클라우드가 승기를 잡을 수 있었던 배경은 그동안 쌓은 클라우드 전문성 덕분으로 풀이된다.

이번 사업은 단순 클라우드 인프라만 사용하는데 그치지 않는다.

△클라우드 네이티브 기반 플랫폼 아키텍처 설계 △사용량에 따라 플랫폼의 자동 확장·축소 기능 제공 △컨테이너·MSA 기반 클라우드 네이티브 플랫폼 구축 △데브옵스 적용을 통한 안전·안정적인 무중단 배포체계 운영 등 클라우드 이점을 최대한 구현해야 한다.

인프라 이전 외에도 클라우드 운영·관리 전문성과 노하우가 없이는 사업 수행이 어렵다.

메가존은 국내 최대 클라우드 관리서비스 제공사(MSP)로 대기업부터 공공까지 다양한 성공 사례와 경험을 보유했다. 네이버클라우드 역시 클라우드보안인증(CSAP)을 획득한 사업자로서 공공 서비스형인프라(IaaS) 시장에서 자리잡는 등 양사 강점이 이번 평가에서 좋은 점수를 얻는데 주효했다.

사업은 향후 3년간 진행된다.

내년까지 민간 클라우드 기반 플랫폼과 서비스를 구축하는데 집중한다. 내후년에는 인공지능 도입까지 타진하는 등 클라우드 기반 신기술 도입도 추진한다.

업계는 이번 국방부 사례가 공공 클라우드 시장에 긍정적 영향을 미칠 것으로 기대한다.

그동안 공공 클라우드 사업이 다수 진행됐지만 주요 시스템 개발 초반부터 민간 클라우드로 구현한 경우는 거의 없다.

업계 관계자는 “보안에 민감한 국방부가 민간 클라우드를 선택했다는 점이 고무적”이라면서 “미국 등 해외도 국방부와 같은 주요 부처가 민간 클라우드를 도입한 후 공공 클라우드 확산이 탄력받았던 것처럼 우리나라도 비슷한 흐름이 이어질 것”이라고 말했다.

반응형
반응형

HyperCLOVA X Vision: 눈을 뜨다

https://me2.do/5XJDTPFL


CLOVA

하이퍼스케일 AI로 플랫폼 경쟁력을 강화하고 비즈니스 시너지를 확장합니다.

clova.ai

서론 
‘백문불여일견’이라는 말처럼 텍스트로 전달할 수 있는 정보량에 비해 시각적인 정보는 훨씬 다양한 의미 관계들을 전달할 수 있습니다. 또한 ‘몸이 100냥이면 눈이 90냥’이라는 말도 인간이 삶을 살아가는 데 시각으로 받아들이는 정보가 얼마나 중요한지 강조하고 있습니다. 만약 HyperCLOVA X (HCX)가 텍스트를 넘어 이미지를 이해할 수 있게 된다면, 가깝게는 문서나 이미지의 처리를 자동화할 수 있고, 더 나아가 HyperCLOVA X를 두뇌로 사용하는 로봇과 같은 독립적인 에이전트가 목표를 수행하는데도 시각 정보를 활용할 수 있을 것입니다.


시각 정보를 올바르게 처리하기 위해서는 대량의 다양한 이미지 · 텍스트 데이터를 활용하여 모델을 학습하는 것이 필수적입니다. 저희는 이를 위해 네이버 내외부에서 고품질의 원천 데이터를 확보해 왔습니다. 해당 데이터가 서로 상충하지 않고 시너지를 낼 수 있도록 학습하는 데에 지금까지 많은 노력을 기울여 왔고, 그 결과 HyperCLOVA X Vision은 문서의 이해를 포함한 여러 가지 능력을 갖추고 있습니다. 기존의 HyperCLOVA X에 이미지를 이해하는 능력을 추가하는 것뿐만 아니라 기존에 가지고 있던 텍스트 관련 능력을 잊지 않고, 안전 관련 요소들도 놓치지 않도록 다방면으로 노력을 기울여 왔습니다. 이 글에서는 HyperCLOVA X Vision의 기술적 개요와 현재의 성능 수준을 간단한 예제 위주로 구성하여 소개해 드리려고 합니다.


HyperCLOVA X Vision 기술 소개
HCX Vision은 기존의 거대 언어 모델(Large Language Model)에 이미지 이해 능력을 더해 거대 시각 언어 모델(Large Vision Language Model)로 발전했습니다. 이를 위해 다양한 시각 및 언어 데이터를 사용하여 추가 학습을 진행했으며, 이 과정에서 이미지와 텍스트를 동시에 이해할 수 있는 능력을 갖추게 되었습니다. 특히, 여러 시나리오에 맞춘 다양한 데이터를 수집하여 다양한 상황에서 시각과 언어 이해 작업을 수행할 수 있도록 했습니다. 예를 들어, 문서 인식이나 이미지 내 텍스트 이해와 같은 작업에서도 뛰어난 성능을 발휘할 수 있습니다.


네이버는 세계 최고 수준의 한국어와 손 글씨 인식 능력을 갖춘 OCR 기술을 보유하고 있습니다. 이러한 경험을 바탕으로, HCX Vision은 문서 처리와 글자 인식 능력을 강화하여 사용자에게 더욱 정확하고 신뢰성 있는 서비스를 제공합니다.
HCX Vision은 초대량의 한국어 데이터로 학습된 거대 언어 모델인 HCX를 기반으로 하고 있습니다. 이에 따라 여러 한국어 및 한국 문화 관련 지식을 포함하고 있으며, 이러한 특성을 HCX Vision에 성공적으로 적용함으로써 한국어 문서와 이미지 내 텍스트 이해에 탁월한 성능을 발휘합니다.


HyperCLOVA X Vision 의 정량 지표

Public Benchmarks

  SEEDv1
(image)
MMMU
(val)
TextVQA
(val)
DocVQA
(test)
ChartQA
(test)
InfographicVQA
(test)
MathVista
(testmini)
VQAv2 Average
GPT-4V 69.1 56.8 78 88.4 78.5 75.1 49.9 77.2 71.63
HCX-VLM 75.6 45.1 77.9 89.8 81 65.2 57.1 81 71.59
 달성률(%) 99.94


HyperCLOVA X Vision의 여러 정량 지표를 소개해 드립니다. 성능 트래킹을 위해 내부적으로 30개에 가까운 지표를 사용하고 있지만, 여기서는 OpenAI GPT-4V와 직접적인 비교가 가능한 지표들만 일부 가져왔습니다. 앞으로 LLM의 Reasoning 능력 향상과 VLM 측면에서의 고해상도 처리를 위한 인코더 구조 변경, 추가적인 Vision Alignment Task 등 출시 이후 올해 하반기에도 점진적으로 성능을 향상할 예정입니다.


K-GED (한국 초 · 중 · 고 검정고시) 성능

Model Correct Answers
GPT-4o 1152/1480 (77.8%)
HCX-VLM 1240/1480 (83.8%)


정량 평가 중에서도 한국향 데이터를 더 많이 학습한 모델이 강점을 보일 수 있는 영역이 무엇이 있을지 고민하다가, 대한민국 초 · 중 · 고등학교 검정고시를 벤치마크로 활용해 보았습니다. 총 1,480개의 사지선다 검정고시 기출 문제로 구성되어 있으며 이미지 형태로 입력했음에도 불구하고 83.8%로 상당히 높은 정답률을 보입니다. 참고로 검정고시의 합격 기준점은 60%이며 77.8%인 GPT-4o보다 높은 성능을 보여줍니다.


예제 기반의 HyperCLOVA X Vision 기능들

하기에서는 분야별 다양한 작업에 대한 예제들을 소개합니다. 한창 개발이 진행 중인 상황이라 100% 완벽하지는 않지만, 거대 모델이 출현하기 이전에 독립된 개별 작업을 별도의 모델로 하나씩 격파하던 기억을 떠올려 보면 직접 개발을 진행하는 입장에서도 격세지감이 드는 상황입니다.


Detailed Image Captioning
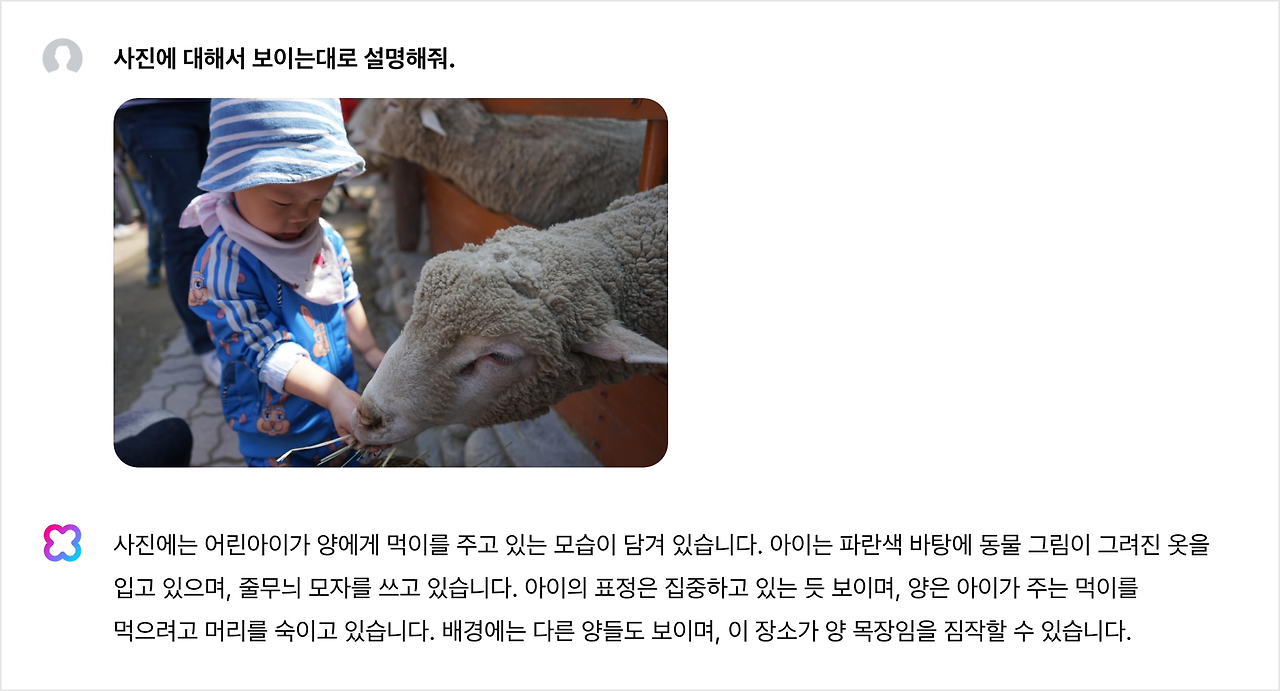
이미지에 대해 상세한 설명을 요구하는 작업으로 이미지 캡셔닝이라고도 불립니다. 별도의 객체 인식 모델을 사용하지 않음에도 불구하고 이미지의 세세한 부분까지도 비교적 정확하게 인식하고 묘사할 수 있습니다.


Reasoning
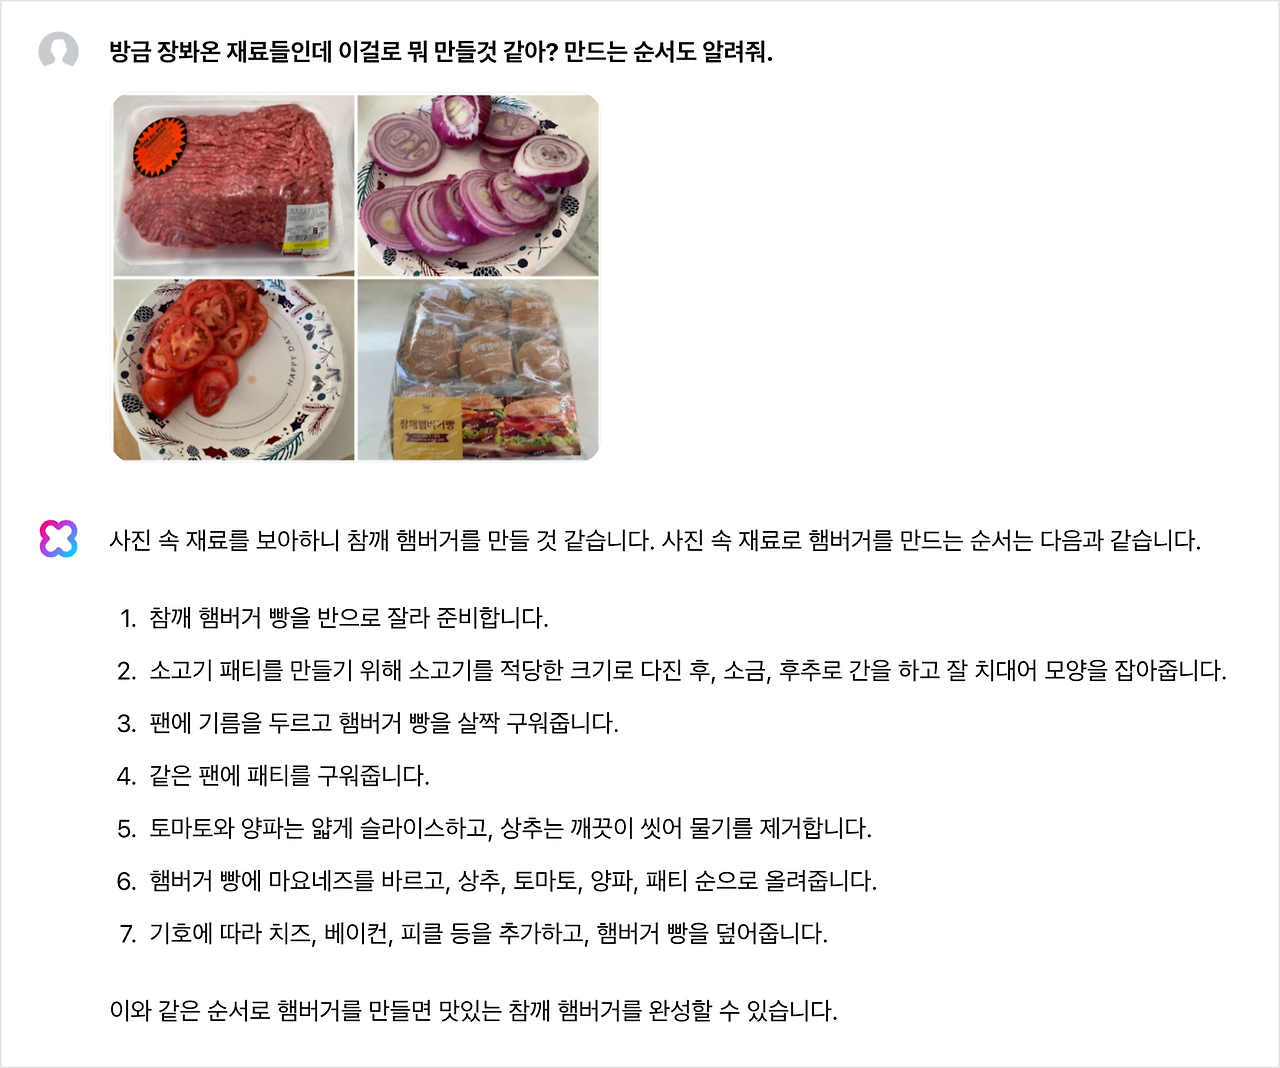
이미지에 대한 상세한 이해를 바탕으로 상황에 대해 추론하거나 다음 단계를 예측할 수 있습니다. 해당 능력은 LLM의 고유 능력을 활용하며, LLM이 여러 비전 기능을 직접적으로 받아들이도록 학습하였습니다.


Entity Recognition
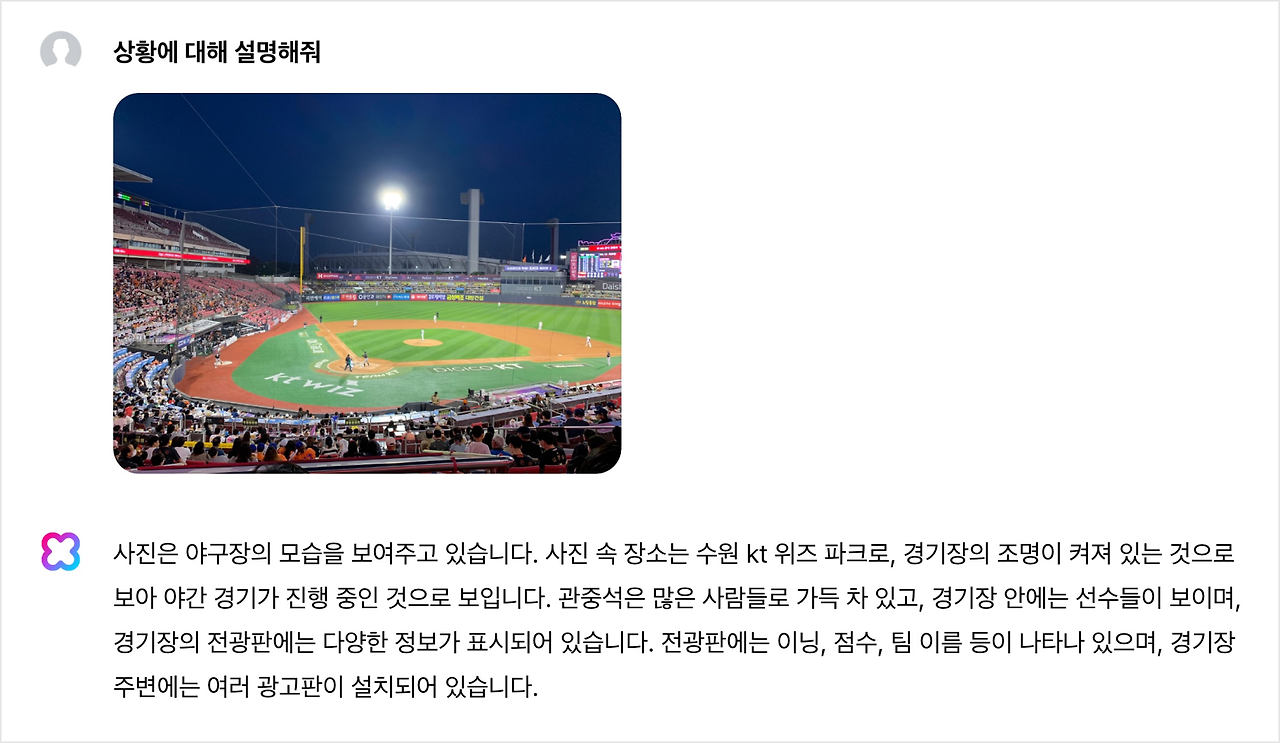
Entity는 의미를 갖는 단위를 지칭하며, 인명, 장소, 제품 등 다양한 형태를 가집니다. HCX Vision을 사용하여 역사적인 인물의 이름, 유명한 장소, 상품명, 음식의 이름을 이미지만으로 이해할 수 있습니다. 현시성 강화를 위한 검색 보강 생성 (Retrieval Augmented Generation; RAG) 등의 방식을 사용하지 않더라도, 기본적으로 학습 데이터에 존재했던 Entity를 무리 없이 인식할 수 있음을 확인했습니다.


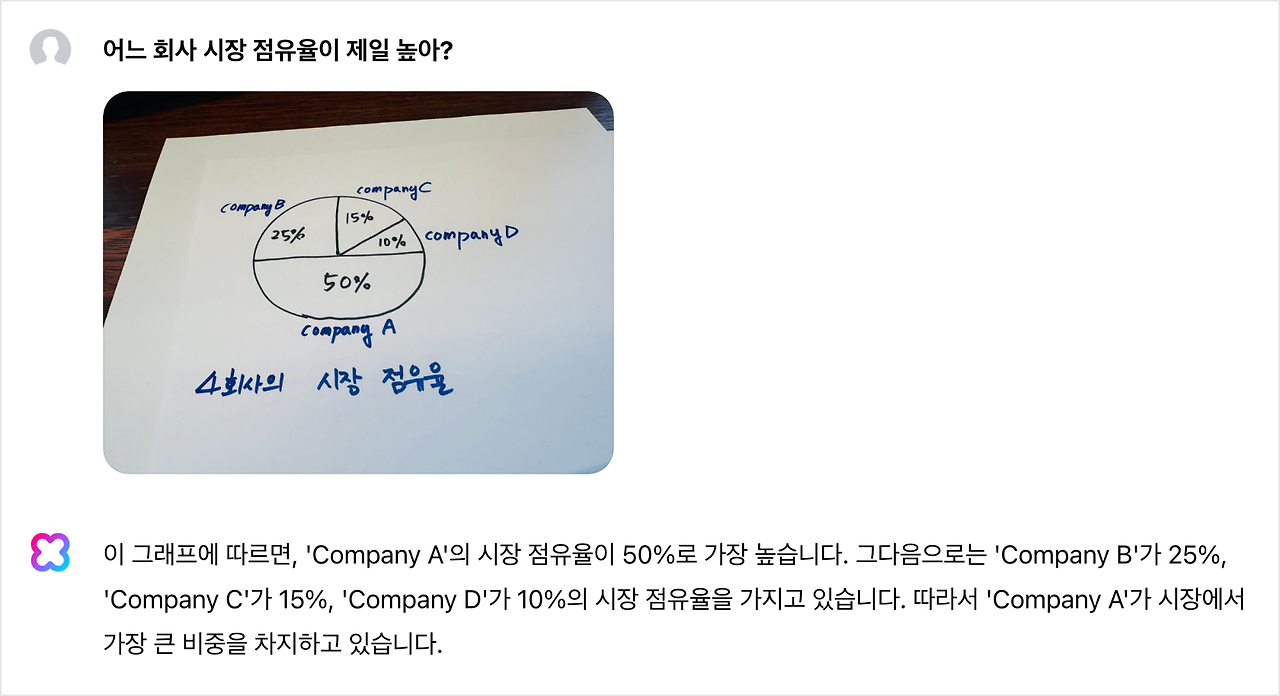
Chart Understanding
사람의 직관적인 이해를 돕기 위하여 수치적인 데이터는 차트의 형태로 유통되는 경우가 많습니다. 사람에게는 쉽지만, 기계의 입장에서는 추상적인 표현을 이해해야 하기 때문에 성능을 내기가 매우 어려운 작업입니다.


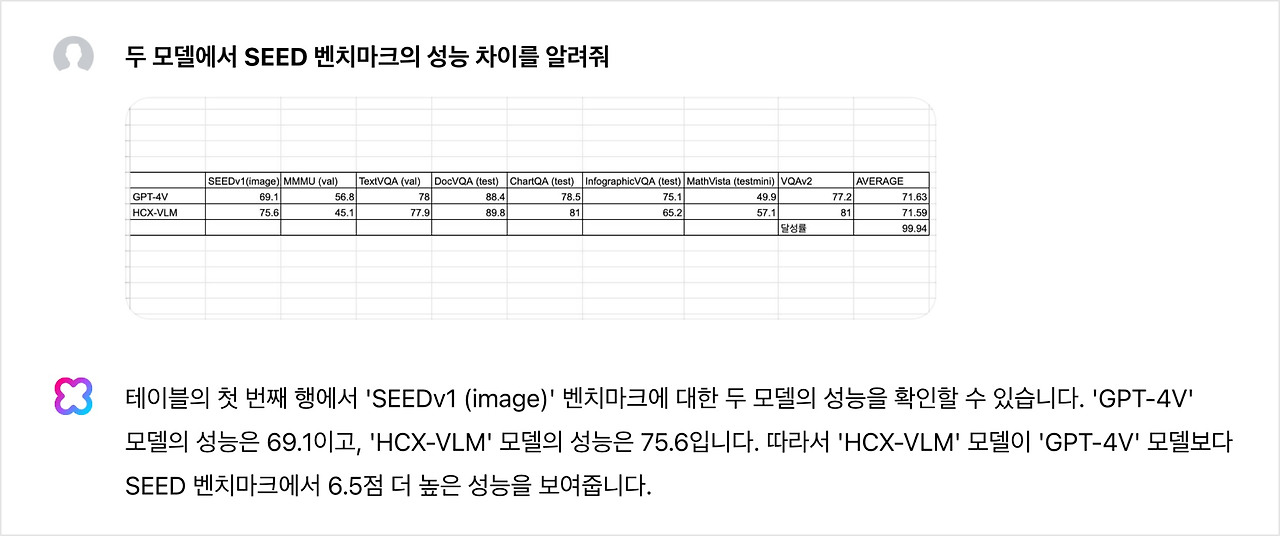
Table Understanding
수치적인 비교 데이터는 표로 나타내는 것이 일반적입니다. 원본 데이터가 Excel이나 CSV 형태일 경우 텍스트 모달을 사용하는 LLM에 입력하여 바로 활용할 수도 있지만, 해당 데이터가 이미지의 캡처본일 경우에는 이미지에 있는 텍스트를 올바르게 인식하고, 그 위치적인 상관관계들을 이해할 수 있어야 프롬프트에 적합한 답변을 생성할 수 있습니다.


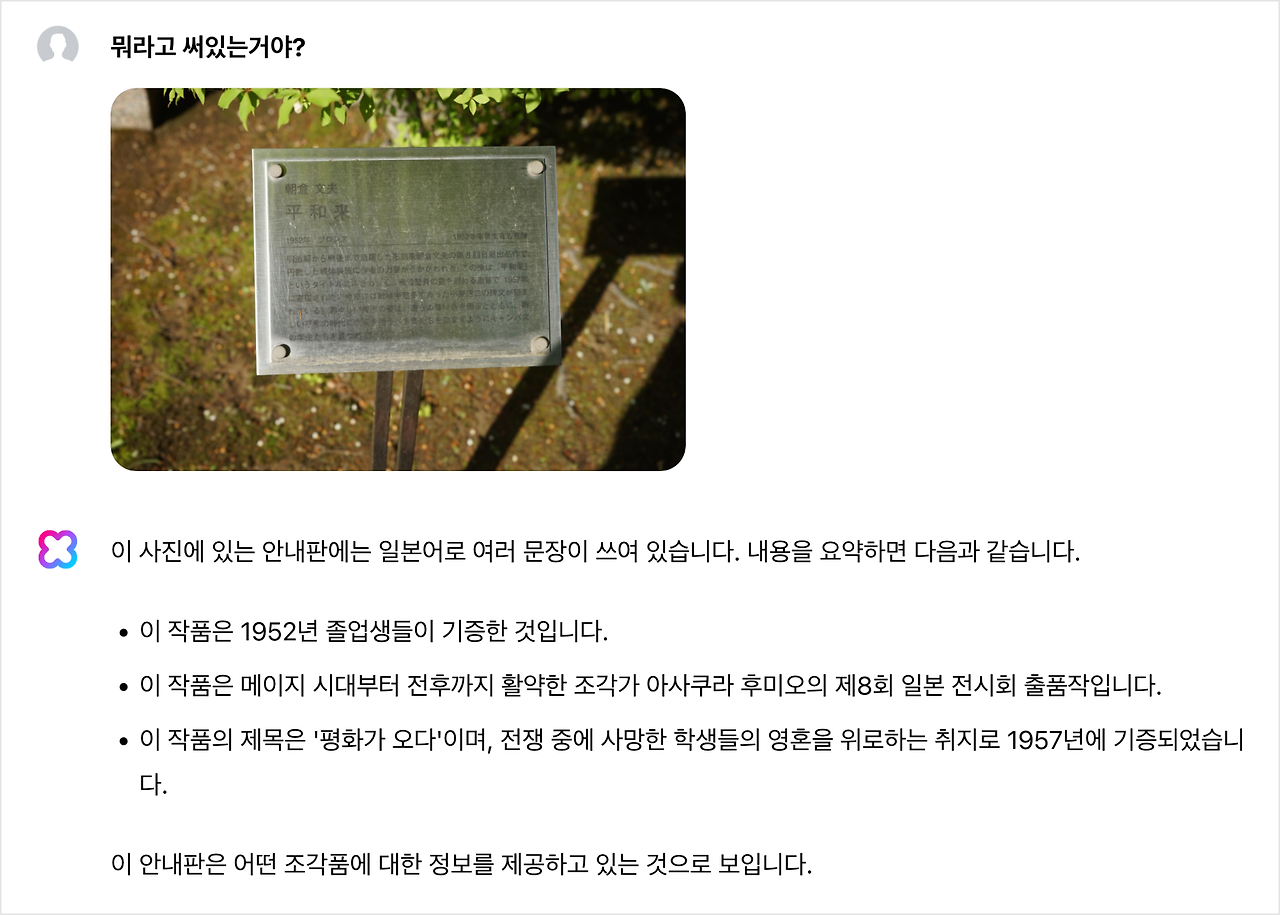
Document Understanding
일반적인 영어와 한글 문서뿐만 아니라, 한자 또는 일본어로 작성된 문서도 이해할 수 있습니다.


Culture and Humor (Meme Understanding)
유머나 문화를 이해하기 위해서는 매우 고차원적인 수준의 능력이 필요합니다. HCX Vision은 이미지와 텍스트 쌍으로 구성된 다량의 데이터를 학습하기 때문에 이러한 밈에 대한 이해가 가능합니다.


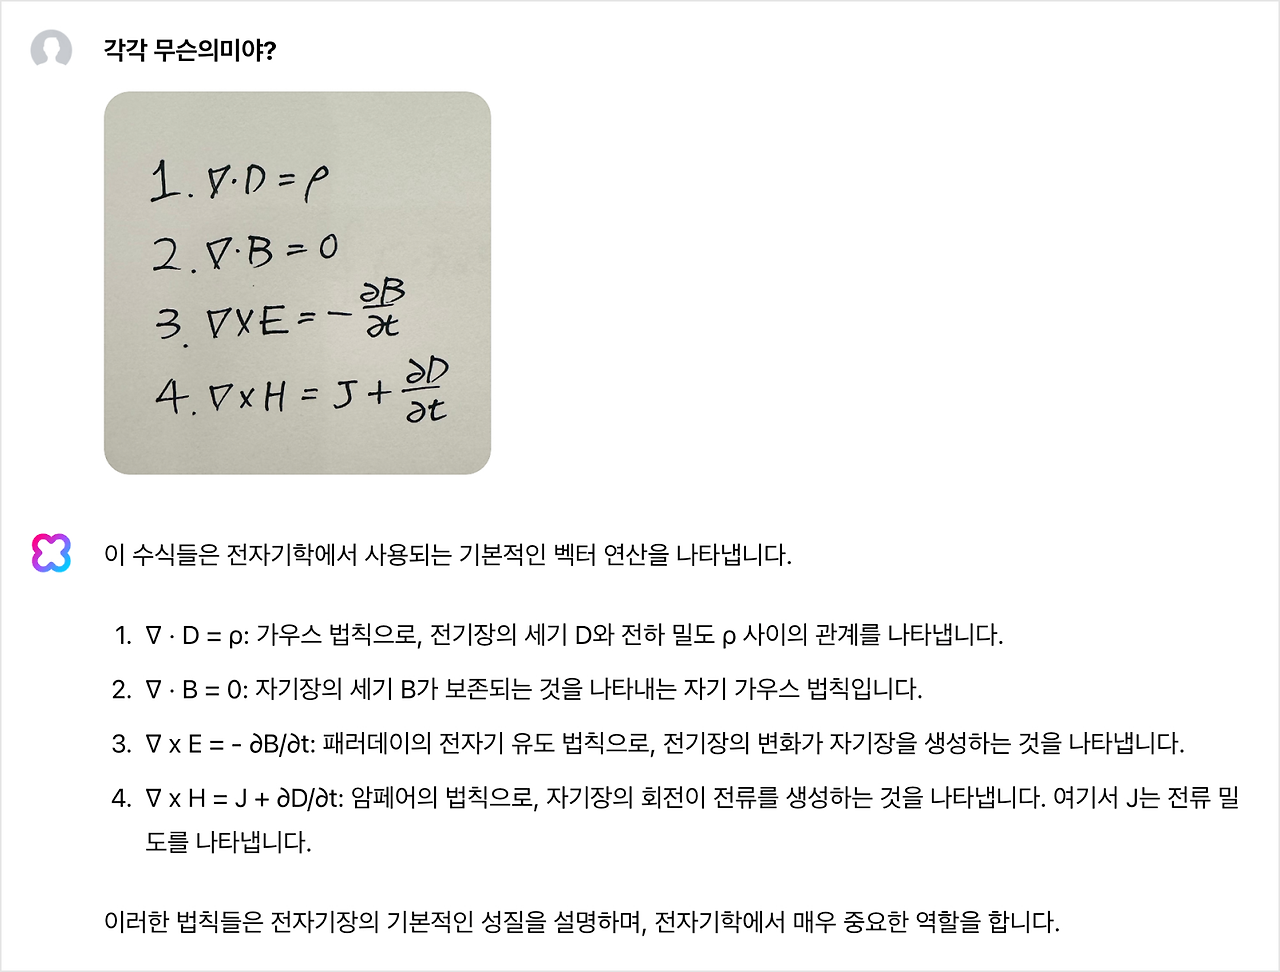
Equation Understanding
렌더링 되어 있는 수식은 사람이 쉽게 읽을 수 있는 데 반해서, 이를 다시 디지털 포맷으로 입력하는 것은 상당히 어려운 작업으로 TeX 문법이 익숙하지 않으면 오랜 시간이 소요됩니다. HCX Vision은 이러한 수동적인 입력 작업을 상당히 간소화할 수 있습니다.


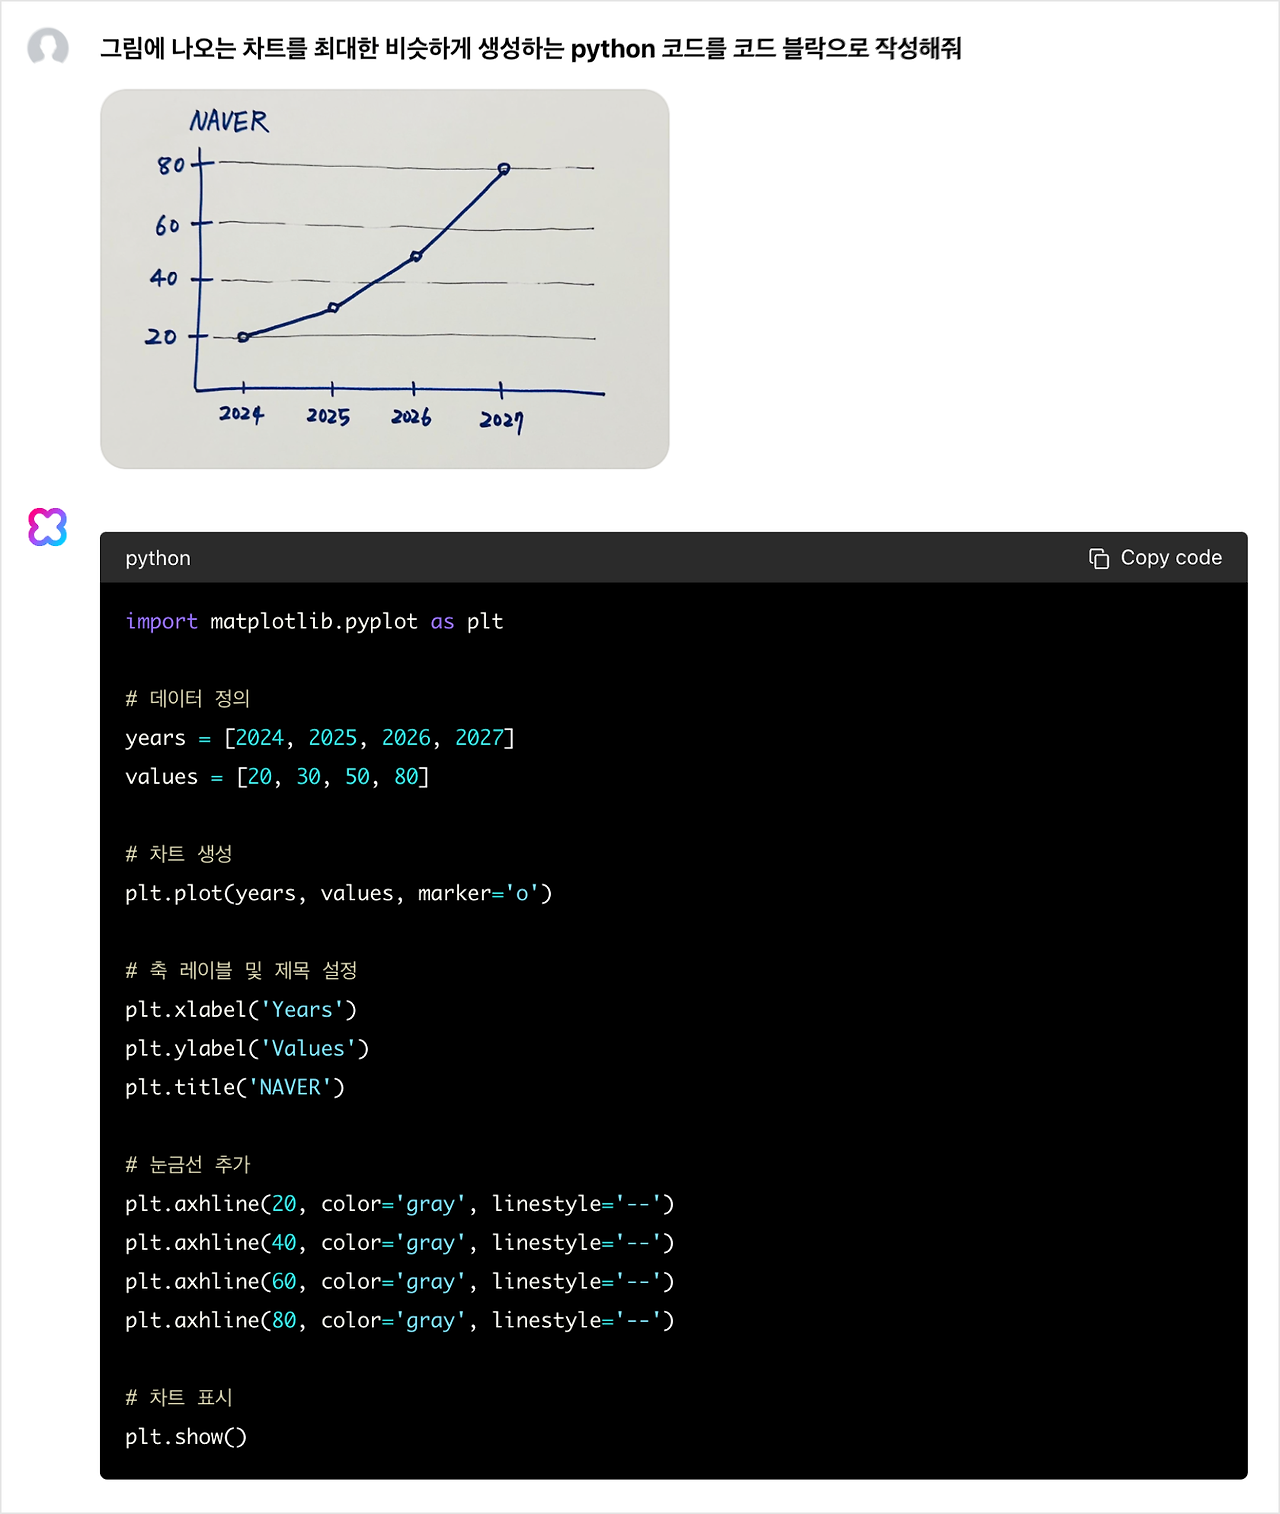
Code Generation
특정 도형이나 차트, 그래프 등을 생성하는 데 필요한 코드를 생성할 수 있습니다.


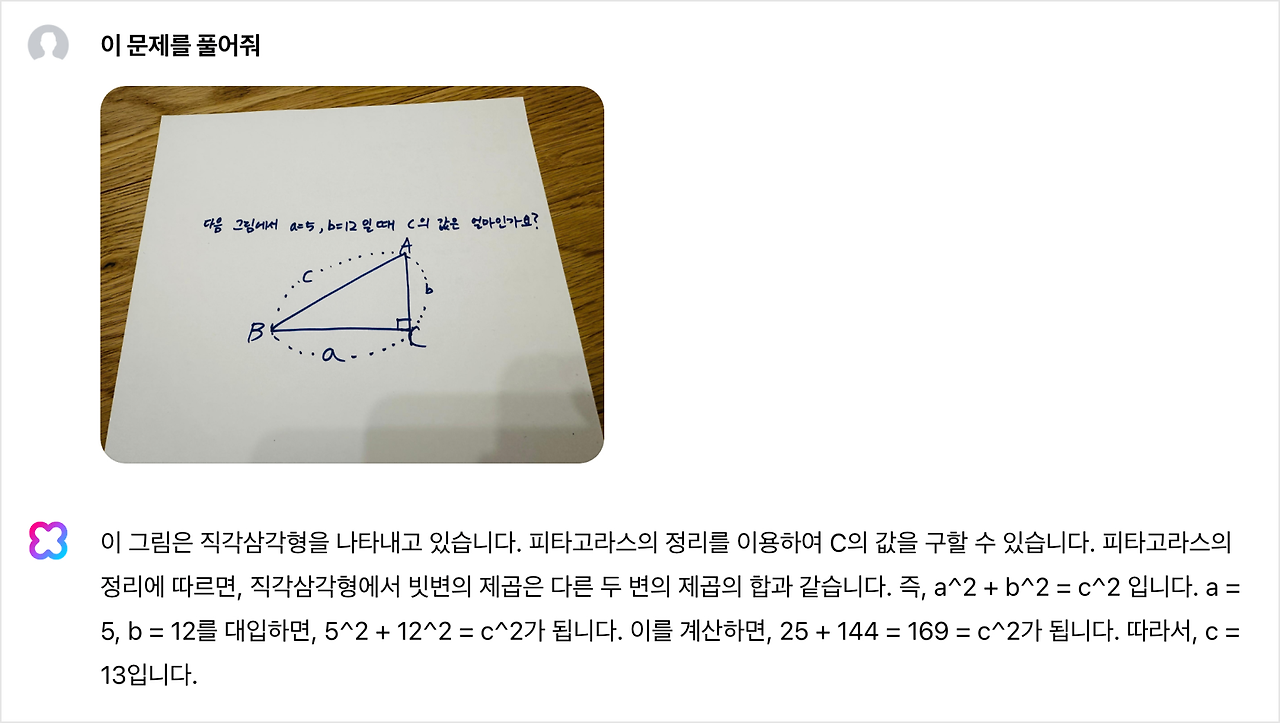
Math Problem Solving
도형이 포함된 수학 문제를 이해하고 풀이를 제공할 수 있습니다.


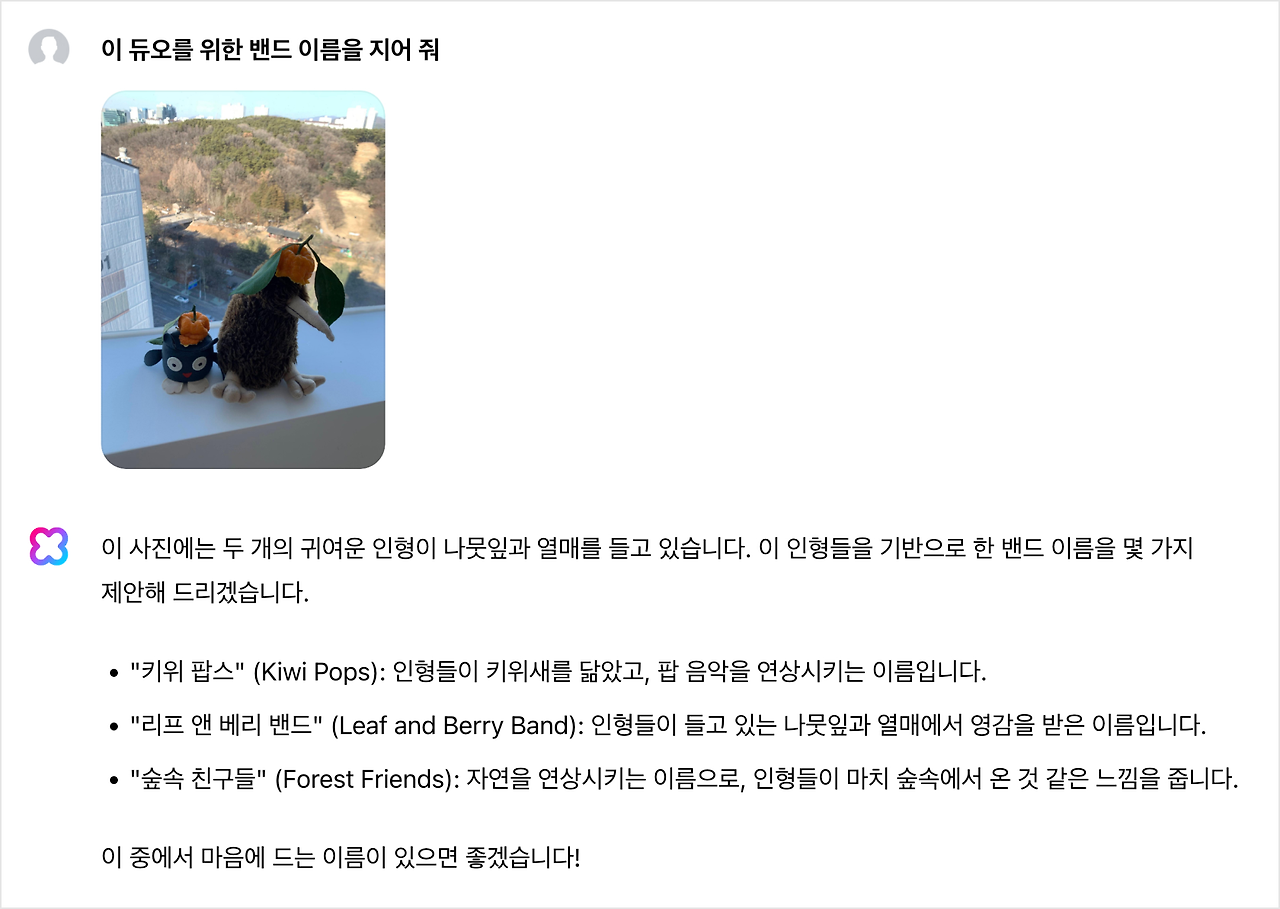
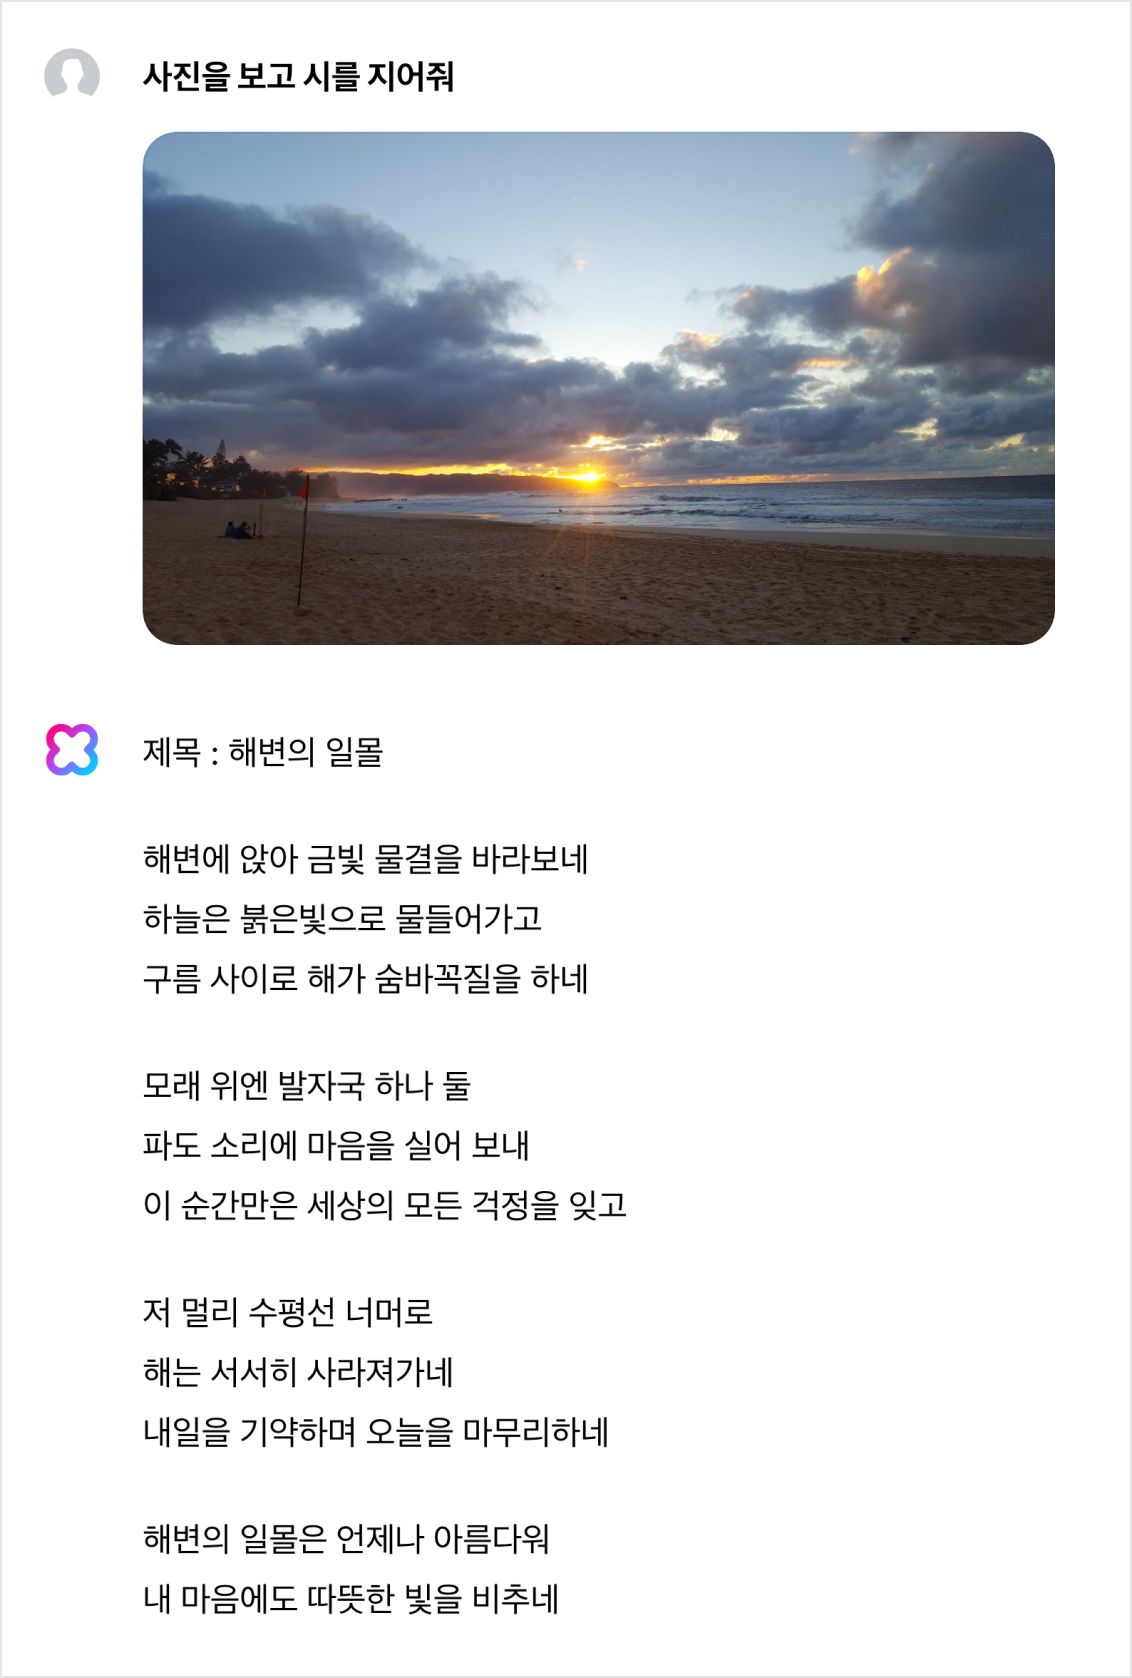
Creative Writing (with Image Grounding)
HCX LLM 본연의 기능에 가깝지만, 이미지에 포함된 요소들을 기반으로 창의적인 글쓰기가 가능합니다.


HyperCLOVA X Vision 미래 전망과 Sovereign AI
현재 하나의 이미지에 대한 이해에서 나아가 수백만 단위의 컨텍스트 길이를 활용하여, 한 시간 이상 분량의 영화를 통째로 이해한다거나, 스트림으로 연속적으로 들어오는 영상을 이해하는 것이 가까운 시일 내에 가능해질 것으로 전망합니다. 이에 추가로 실시간 처리 기술까지 동반된다면 AI가 독립적인 개체로써 상황에 유연하게 대응하는 것이 가능해지고 정말 영화에서나 보던 로봇이 일상생활에 녹아들어 유용함을 제공해 주는 시대가 머지않았습니다.


LVLM도 Text-only의 LLM과 마찬가지로 지역이나 문화적 배경에 따라 다양한 가치관을 이해하거나 표현할 수 있어야 합니다. 특히 시각적인 기호 등의 해석에서도 Sovereignty가 중요해질 전망이고 결국 이러한 데이터를 유리하게 확보하고 선점할 수 있는 그룹이 사람들에게 더 유용하고 안전한 AI를 개발할 수 있습니다. 네이버는 대한민국 최고의 플랫폼으로써 필요한 데이터를 효과적으로 확보할 수 있는 유리한 위치에 있습니다.

반응형
반응형

[python] Working With Mathematical Operations and Permutations. 수학적 연산과 순열


https://blog.stackademic.com/ultimate-python-cheat-sheet-practical-python-for-everyday-tasks-c267c1394ee8


Ultimate Python Cheat Sheet: Practical Python For Everyday Tasks

(My Other Ultimate Guides)

blog.stackademic.com


1. Basic Arithmetic Operations
    To perform basic arithmetic:

sum = 7 + 3  # Addition
difference = 7 - 3  # Subtraction
product = 7 * 3  # Multiplication
quotient = 7 / 3  # Division
remainder = 7 % 3  # Modulus (Remainder)
power = 7 ** 3  # Exponentiation


2. Working with Complex Numbers
    To work with complex numbers:

z = complex(2, 3)  # Create a complex number 2 + 3j
real_part = z.real  # Retrieve the real part
imaginary_part = z.imag  # Retrieve the imaginary part
conjugate = z.conjugate()  # Get the conjugate


3. Mathematical Functions
    Common math functions:

import math
root = math.sqrt(16)  # Square root
logarithm = math.log(100, 10)  # Logarithm base 10 of 100
sine = math.sin(math.pi / 2)  # Sine of 90 degrees (in radians)


4. Generating Permutations
    Easy way to generate permutations from a given set:

from itertools import permutations
paths = permutations([1, 2, 3])  # Generate all permutations of the list [1, 2, 3]
for path in paths:
    print(path)


5. Generating Combinations
    Easy way to generate combinations:

from itertools import combinations
combos = combinations([1, 2, 3, 4], 2)  # Generate all 2-element combinations
for combo in combos:
    print(combo)


6. Random Number Generation
    To get a random number:

import random
num = random.randint(1, 100)  # Generate a random integer between 1 and 100


7. Working with Fractions
    When you need to work with fractions:

from fractions import Fraction
f = Fraction(3, 4)  # Create a fraction 3/4
print(f + 1)  # Add a fraction and an integer


8. Statistical Functions
   To get Average, Median, and Standard Deviation:

import statistics
data = [1, 2, 3, 4, 5]
mean = statistics.mean(data)  # Average
median = statistics.median(data)  # Median
stdev = statistics.stdev(data)  # Standard Deviation


9. Trigonometric Functions
    To work with trigonometry:

import math
angle_rad = math.radians(60)  # Convert 60 degrees to radians
cosine = math.cos(angle_rad)  # Cosine of the angle


10. Handling Infinity and NaN
    To work with Infinity and NaN:

import math
infinity = math.inf  # Representing infinity
not_a_number = math.nan  # Representing a non-number (NaN)


반응형
반응형

[python] 폴더 안의 파일들 이름의 공백 또는 - 를 언더바로 변경하는 프로그램


공백( ) 또는 하이픈(-)을 언더바(_)로 변경하는 프로그램을 작성할 수 있습니다. 이 프로그램은 지정된 폴더 내 모든 파일의 이름을 확인하고, 공백 또는 하이픈이 포함된 경우 이를 언더바로 대체하여 이름을 변경합니다.


# 파이썬 컴파일 경로가 달라서 현재 폴더의 이미지를 호출하지 못할때 작업디렉토리를 변경한다. 
import os
from pathlib import Path
# src 상위 폴더를 실행폴더로 지정하려고 한다.
###real_path = Path(__file__).parent.parent
real_path = Path(__file__).parent
print(real_path)
#작업 디렉토리 변경
os.chdir(real_path) 


def replace_spaces_in_filenames(folder_path):
    # 폴더 내 모든 파일을 반복
    for filename in os.listdir(folder_path):
        # 파일의 전체 경로 생성
        old_file_path = os.path.join(folder_path, filename)

        # 파일 이름에 공백이 있는지, -도 _로 변경 확인
        if ' ' in filename or  '-' in filename:
            # 공백을 언더바로 대체
            new_filename = filename.replace(' ', '_').replace('-', '_')
            new_file_path = os.path.join(folder_path, new_filename)

            
            # 파일이 존재할경우 덮어쓸지, 빠져나갈지 
            if os.path.exists(new_file_path):
                overwrite = input(f"'{new_file_path}' already exists. Overwrite? (y/n): ")
                if overwrite.lower() == 'y':
                    os.remove(new_file_path)
                else:
                    print("Operation canceled.")
                    exit()
            # 파일 이름 변경
            os.rename(old_file_path, new_file_path)
            
            
            print(f"Renamed: '{filename}' -> '{new_filename}'")
        else:
            print(f"No change: '{filename}'")

# 사용 예시
folder_path = 'path_to_your_folder'  # 여기에 폴더 경로를 입력하세요 
replace_spaces_in_filenames(folder_path)

프로그램 설명

  1. os 모듈: 파일 경로와 관련된 작업을 수행하기 위해 os 모듈을 사용합니다.
  2. 폴더 내 파일 탐색:
    • os.listdir(folder_path)를 사용하여 지정된 폴더 내의 모든 파일 및 하위 디렉토리 이름을 가져옵니다.
    • for filename in os.listdir(folder_path)를 사용하여 각 파일을 순회합니다.
  3. 공백과 하이픈을 언더바로 변경:
    • if ' ' in filename or '-' in filename: 조건문을 사용하여 파일 이름에 공백 또는 하이픈이 포함되어 있는지 확인합니다.
    • filename.replace(' ', '_').replace('-', '_')를 사용하여 공백과 하이픈을 언더바로 대체합니다.
  4. 파일 이름 변경:
    • os.rename(old_file_path, new_file_path)를 사용하여 파일 이름을 변경합니다.
  5. 사용 방법:
    • folder_path에 파일 이름을 변경할 폴더의 경로를 입력합니다.
    • 프로그램을 실행하면 폴더 내 모든 파일의 이름에서 공백과 하이픈이 언더바로 변경됩니다.

사용 예시

폴더 경로를 지정하여 프로그램을 실행하면, 그 폴더 안의 모든 파일 이름에서 공백 또는 하이픈이 언더바로 변경됩니다. 예를 들어, path_to_your_folder가 C:/Users/YourName/Documents/TestFolder인 경우:

반응형

+ Recent posts